16GB GPU-তে লোকাল AI কোডিং: Strata, OpenCode এবং Qwen3.8
Table of Contents
16GB GPU-তে লোকাল কোডিং এজেন্ট সীমিত উন্নয়ন কাজের জন্য ব্যবহারযোগ্য বিকল্প। Strata এবং OpenCode লোকাল inference-এর সঙ্গে ফাইল সম্পাদনা, shell command এবং test execution যুক্ত করে। RTX 4060 Ti-তে চালানো প্রকাশিত Qwen3.8-Flash-Next একটি application, পরের পরিবর্তন এবং racing-game prototype paid inference call ছাড়াই সম্পূর্ণ করেছে।
সাবস্ক্রিপশন বদলাতে আরও বিস্তৃত পরীক্ষা দরকার। প্রকাশিত ফলাফল একটি মেশিনে কাজ করা setup দেখায়। এগুলো ভাষা, repository বা কঠিন debugging task জুড়ে paid coding service-এর সমতা প্রমাণ করে না। হার্ডওয়্যারে 64GB system RAM-ও আছে, যা model-এর বড় অংশ বহন করে।
মূল বিষয়
- 16GB GPU memory বোঝায়, প্রকাশিত configuration-এর জন্য দরকারি মোট memory নয়।
- Prompt reuse গুরুত্বপূর্ণ, কারণ coding agent বারবার overlap করা conversation history পাঠায়।
- Reasoning-এর বাজেট দরকার, যাতে planning code ও tool call-এর জন্য জায়গা রাখে।
- Generated test পাস করা আংশিক প্রমাণ, Docker ও gameplay-এর জন্য আলাদা check দরকার।
- শূন্য API খরচ ownership cost বাদ দেয়, electricity ও maintenance time-সহ।
প্রয়োজনীয়তা: একটি compatible computer, নির্বাচিত model-এর জন্য যথেষ্ট free storage, Git, npm-সহ Node.js এবং terminal tool-এর পরিচিতি। প্রকাশিত IQ3_S setup-এর সঙ্গে 64GB RAM মিলিয়ে নিন। অন্য configuration পরীক্ষা করতে বর্তমান Strata installer ব্যবহার করুন।
সময় ও কঠিনতা: Intermediate। task completion speed মূল্যায়নের আগে বড় model download ও installation-এর জন্য সময় রাখুন। প্রকাশিত task timing setup বাদ দেয়।
পরীক্ষিত Configuration
| Component | প্রকাশিত configuration |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16GB VRAM |
| CPU | Intel Core i5-11600K |
| System memory | 64GB RAM |
| Storage | NVMe SSD |
| Model | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Inference engine | Strata |
| Coding agent | OpenCode |
| Configured context | 65,536 token |
| Configured output limit | 16,384 token |
NetworkCoder-এর প্রকাশিত configuration ও result এই সংখ্যাগুলো দেয়। Test repository 28 second-এ 46.84GiB expert weight load করার কথা বলে, যেখানে 4,431 expert GPU memory-এর 8.45GiB দখল করে। এই measurement পরীক্ষিত run বর্ণনা করে, অন্য engine version-এ একই allocation নিশ্চিত করে না।
বর্তমান compatibility এই test-এর চেয়ে বিস্তৃত। 6 October 2026-এ পরীক্ষা অনুযায়ী, Strata project অন্তত 12GB VRAM-সহ নির্বাচিত NVIDIA ও AMD card এবং 32GB RAM system-এর জন্য ছোট model option document করে। এই option 16GB GPU, 64GB RAM, IQ3_S experiment পুনরাবৃত্তি করে না। hardware কেনার আগে নির্দিষ্ট GPU, model variant এবং runtime support পরীক্ষা করুন।
Model কোথায় থাকে
Mixture of experts, বা MoE, প্রতিটি token-এর জন্য model-এর expert network-এর একটি subset সক্রিয় করে। প্রতি step-এ প্রতিটি parameter ব্যবহার করার তুলনায় এতে active computation কমে। বাকি weight-এর জন্য storage এবং computation-এ যাওয়ার পথ দরকার।
Strata-এর hybrid execution ঘনঘন ব্যবহৃত expert GPU-তে রাখে এবং expert collection system RAM-এ ধরে। CPU uncached expert-এর calculation করে, GPU cached expert সামলায়। Storage model file ও lookup data-ও রাখে। system পুরো 125B model 16GB VRAM-এ ঢোকায় না।
GPU memory-এর একাধিক ব্যবহার আছে। Runtime allocation, attention state এবং expert cache একটি সীমিত resource ভাগ করে। context-এর জন্য বেশি জায়গা দিলে অবশিষ্ট expert-cache capacity বদলে যায়। বর্তমান Strata version KV-cache streaming-ও সমর্থন করে, তাই পুরনো configuration-এর তুলনায় exact placement আলাদা। আপনার engine version-এর জন্য technical documentation দেখুন।
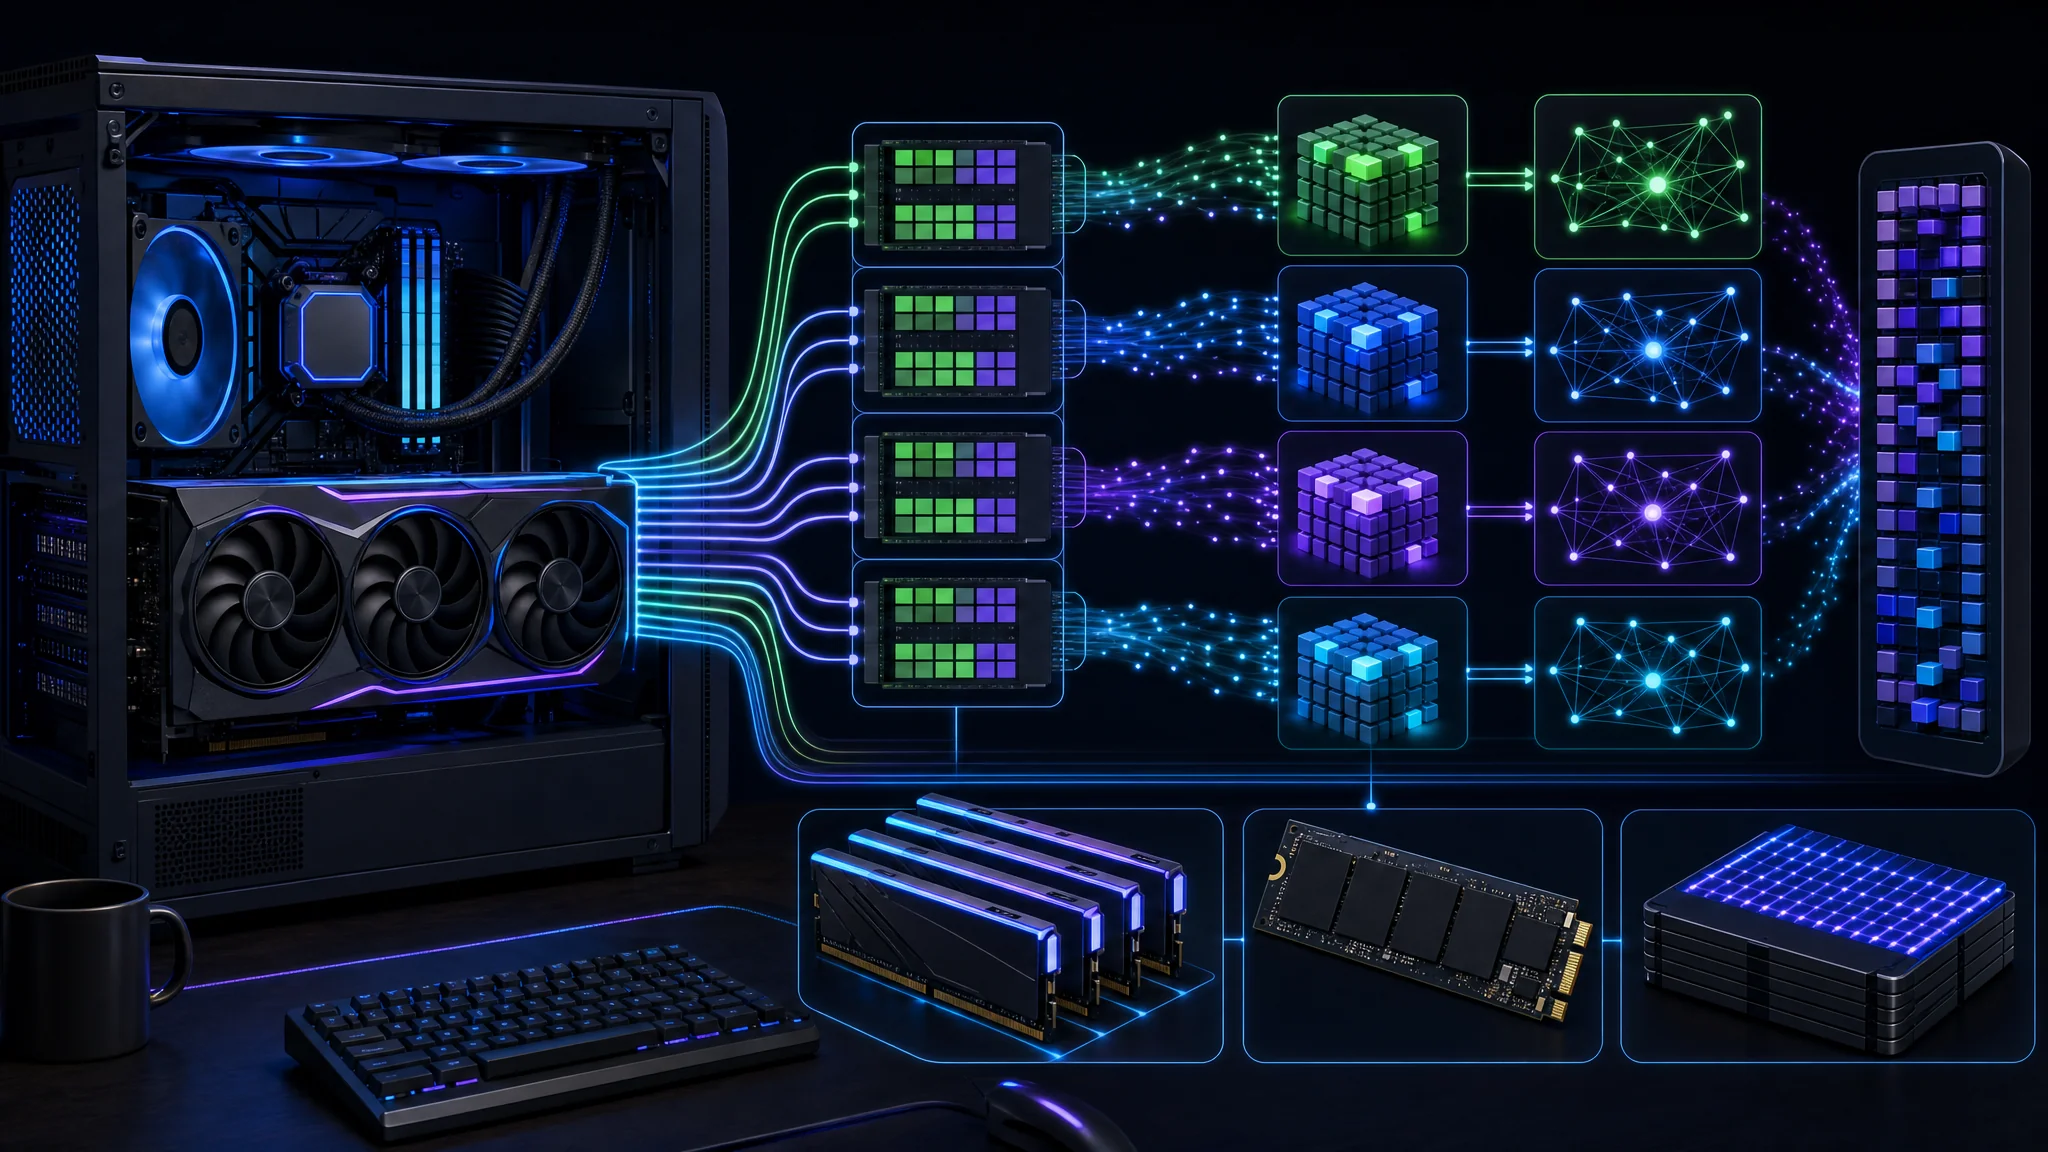
GPU inference system-এর একটি অংশ, যার সঙ্গে CPU execution, system RAM ও storage যুক্ত
Prompt reuse speed বদলায়
একটি coding agent loop চালায়: task পড়ে, tool action চায়, result পায় এবং পরের action ঠিক করে। File content, error ও test output conversation-এ জমে। Agent context compact বা select-ও করে, তাই প্রতিটি implementation-এ অপরিবর্তিত পুরো history চিরকাল resend হয় না।
Prefill generation-এর আগে input token process করে। Decode response তৈরি করে। দ্রুত decode কিন্তু ধীর repeated prefill থাকা system-এ tool call-এর মাঝেও অপেক্ষা থাকে।
প্রকাশিত 44K-token timing prefix reuse ব্যবহার করেছে। Strata আগে process করা conversation content পুনরায় ব্যবহার করেছে এবং growing prompt প্রায় এক থেকে তিন second-এ প্রস্তুত হয়েছে। এটি চলমান agent session-এর জন্য উপযোগী evidence। এক second-এ 44,000 সম্পূর্ণ নতুন token শূন্য থেকে process করার প্রমাণ এটি নয়।
| Measurement | কী record করবেন |
|---|---|
| Cold prompt | reusable prefix state ছাড়া নতুন content-এর সময় |
| Warm continuation | existing context-এ tool result যোগ করার পরের সময় |
| Generation speed | response চলাকালে প্রতি second-এ token |
| Task duration | planning, generation, tool, test ও retry একসঙ্গে |
দুটি cache আলাদা কাজ করে। Expert cache ঘনঘন ব্যবহৃত weight GPU computation-এর কাছে রাখে। Prefix reuse আগের input-এর কাজ পুনরায় করা এড়ায়। উচ্চ expert-cache hit rate prompt-cache hit প্রমাণ করে না।
Task কী দেখিয়েছে
| Task | প্রকাশিত সময় | প্রকাশিত ফলাফল |
|---|---|---|
| Build task manager | 3m 38s | Express API, interface, 5/5 test |
| Editing ঠিক করা ও date যোগ | 4m 58s | change সম্পূর্ণ, 6/6 test |
| Export/import ও packaging যোগ | 3m 48s | 7/7 test, Docker build অনিশ্চিত |
| Racing game, প্রথম চেষ্টা | 6m 35s | reasoning-এর সময় output শেষ, code নেই |
| Racing game, budgeted retry | 4m 51s | game generated, JavaScript syntax checked |
প্রকাশিত result file প্রথম task-এ 48–52 token per second, দ্বিতীয়টিতে 40–43 এবং তৃতীয়টিতে 37–44 output speed record করে। “Up to 52” এই observation-এর peak, প্রতিটি task-এর sustained rate নয়।
প্রথম তিনটি task একটি application বাড়ায়। 5/5, 6/6 ও 7/7 count পরপর test suite বোঝায়। এগুলো যোগ করলে 18টি independent capability প্রমাণ হয় না। একই agent লেখা test coverage ও meaningful assertion-এর জন্য review দরকার।
Environmental recovery কাজের অংশ ছিল। Agent একটি অনুপযুক্ত shell command থেকে recover করেছে এবং testing-এর সময় stale application server শনাক্ত করেছে। এগুলো useful behavior, তবে shared development environment-এ existing process terminate করার জন্য deliberate permission দরকার।
Docker verify হয়নি। Agent Dockerfile লিখেছে, কিন্তু build-এর জন্য running Docker engine পায়নি। Container-এর বাইরে application test pass করা working image প্রমাণ করে না। Game retry syntax check করেছে ও browser খুলেছে, কিন্তু gameplay-এর direct visual confirmation agent-এর ছিল না।
Output-এর জন্য জায়গা রাখুন
{
  "reasoning_budget_tokens": 8000
}
এই setting বিদ্যমান strata-iq3_s.json configuration-এ merge করুন, অন্য field রেখে, তারপর নির্বাচিত Strata model restart করুন। এটি Strata setting, replacement OpenCode configuration file নয়। Startup output-এ active budget verify করুন।
Strata একটি hard reasoning budget document করে, যা thinking phase শেষ করে answer-এর দিকে যায়। Request-level value configured default override করে। এই setting low বা high-এর মতো general reasoning-effort instruction থেকে আলাদা।
প্রথম game attempt planning-এর সময় 16,384-token allowance শেষ করেছে। Retry 8,000-token thinking budget প্রয়োগ করে code দিয়েছে। এই workload-এ bounded reasoning phase ব্যবহার করার পক্ষে এটি evidence। প্রতিটি task-এর জন্য 8,000 সেরা setting প্রমাণিত নয়।
Remaining output allowance maximum, reservation guarantee নয়। 16,384 total limit-এর মধ্যে 8,000-token cap পুরো খরচ হলে other overhead-এর আগে প্রায় 8,384 token থাকে। Result log retry-তে 11,054 token লেখা দেখায়, reasoning বনাম code-এর complete breakdown ছাড়া। একে একই limit-এর মধ্যে 8,000 reasoning token plus 11,054 code token ভাববেন না।
Narrow edit-এর জন্য ছোট budget ব্যবহার করুন, তারপর বেশি analysis দরকার এমন task-এ বড় budget পরীক্ষা করুন। Complete file output, finish status ও test result দেখুন। বেশি planning time কেবল delivered change উন্নত করলে useful।
Strata ও OpenCode যুক্ত করুন
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
এটি Linux setup entry point। বর্তমান installation instruction review করুন এবং documented Windows path-এর জন্য START-HERE.bat ব্যবহার করুন। Reported configuration-এর কাছাকাছি যেতে original Qwen3.8-Flash-Next IQ3_S variant এবং 65,536-token context select করুন। Benchmark note-এর সঙ্গে engine version ও selected model file সংরক্ষণ করুন।
npm install -g opencode-ai
OpenCode install করুন
official instruction
ব্যবহার করে। আলাদা terminal-এ STRATA_BASE_URL-কে Strata প্রদর্শিত local API base হিসেবে set করুন, সঙ্গে /v1 suffix রাখুন। এই setup-এ inference local machine-এ bound রাখুন।
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Provider block ~/.config/opencode/opencode.json-এ merge করুন, existing setting রেখে। এই
published example configuration
environment variable থেকে local endpoint load করে। OpenCode
custom provider
ও
environment substitution
document করে।
local একটি placeholder credential, example-এর unauthenticated local setup-এর মতো। এটি server secure করে না। আপনার Strata instance authentication enable করলে উপযুক্ত local secret mechanism দিয়ে configured credential দিন।
Disposable project copy-তে opencode শুরু করুন এবং configured model select করুন। Code পাঠানোর আগে selected provider verify করুন। Client-side context declaration server-এর configured context বাড়ায় না, এবং output-এর জন্য জায়গা দরকার হলে 65,536-token window input-এর জন্য 65,536 token ছাড়ে না।
Local inference ও permission
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Agent evaluate করার সময় এই initial permission OpenCode configuration-এ merge করুন। Permission documentation available control ব্যাখ্যা করে। Inference যেখানেই চলুক, file change ও shell execution আপনার machine-এ প্রভাব ফেলে।
Local inference প্রতিটি tool-কে local করে না। Package download, web tool, external integration ও optional sharing network service জড়িত করে। Private repository সামলানোর আগে enabled tool review করুন। “Model locally runs” claim “nothing leaves the computer”-এর চেয়ে সংকীর্ণ।
প্রথম run-এর সমস্যা সমাধান
| Symptom | আগে কী check করবেন |
|---|---|
| Provider unavailable | Strata চলছে এবং environment variable OpenCode process-এ পৌঁছায় |
| Selection-এ model নেই | Provider ID ও model ID saved configuration-এর সঙ্গে মেলে |
| Context-limit error | Prompt length plus requested output server-এর active window-এ fit করে |
| Code ছাড়া planning | Reasoning budget, total output limit ও finish status |
| Slow continuation | Prefix reuse, memory pressure, expert-cache behavior ও competing process |
| Docker command fail | শুধু command-line client নয়, functioning engine available |
একবারে একটি setting বদলান এবং saved starting state থেকে একই task repeat করুন। এতে configuration improvement-কে আলাদা prompt বা সহজ test থেকে পৃথক করা যায়।
এটি কি Subscription বদলায়?
| Local setup test করার মূল্য আছে | অন্য option available রাখুন |
|---|---|
| বিদ্যমান compatible hardware | Untested workload-এর জন্য hardware কেনা |
| Bounded application change | বড় unfamiliar repository ও কঠিন migration |
| Repeatable acceptance test | Correctness check করার reliable উপায়হীন task |
| Runtime maintenance-এর সময় | কম setup ও support overhead দরকার এমন কাজ |
Zero API spend meaningful, বিশেষ করে hardware আগে থেকেই থাকলে। এটি electricity, hardware depreciation, storage ও environment maintenance time বাদ দেয়। Displayed zero-cost field-ও এই খরচ মাপে না।
Subscription comparison-এর জন্য matched task দরকার। একই starting repository, instruction ও acceptance check দুই system-এ চালান। Elapsed time-এর পাশে retry ও human correction record করুন। Successful retry মাত্র report না করে full workflow evaluate করার সময় failed first game attempt রাখুন।
Useful local agent-এর universal superiority দরকার নেই। এটি যদি routine edit নির্ভরযোগ্যভাবে সামলায় এবং কঠিন task-এর ছোট set অন্য tool-এর জন্য রাখে, তবে আপনার দরকারি paid service ইতিমধ্যে বদলে যায়। নিজের project-এ accepted work দেখে সিদ্ধান্ত নিন।
Demonstration ও পরের ধাপ
আরও দেখা: 125B local coding-agent demonstration । উপরের reported measurement published test-এর, এই article-এর জন্য independently performed benchmark নয়।
- একটি ছোট task পুনরায় চালান fixed acceptance criteria ও saved starting revision দিয়ে।
- Cold ও warm turn measure করুন এবং prefix reuse-কে cold prefill speed ভাববেন না।
- Packaging আলাদাভাবে verify করুন successful image build, startup ও container-level check দিয়ে।
- Generated test inspect করুন এবং implementation যে case ভাবেনি সেগুলো যোগ করুন।
- Completed work compare করুন subscription বদলানোর আগে current coding tool-এর সঙ্গে।
Hardware planning-এর জন্য, local AI model ও GPU context guide পড়ুন। Hosted-model behavior-এর জন্য OpenRouter provider routing ও cost দেখুন।
Related Posts