২০২৬ সালের স্থানীয় AI: 27B মডেল Sonnet 4.6-কে ছাড়িয়েছে, আর হার্ডওয়্যার কেনার সুযোগ শেষ হচ্ছে
Table of Contents
একটি ডাউনলোডযোগ্য মডেল, যা একটি ভোক্তা গ্রাফিক্স কার্ডেই চলে, এখন সামগ্রিক বুদ্ধিমত্তা সূচকে একটি শীর্ষ API মডেলকে ছাড়িয়ে গেছে। Qwen3.8 27B হলো ২০২৬ সালের আগস্টে প্রকাশিত ওপেন-ওয়েট ভিশন-ল্যাঙ্গুয়েজ মডেল। এর টার্নারি পুনঃপ্যাকেজ Bonsai 2 27B একই ওয়েটকে 5.53 GiB-তে সংকুচিত করে। এরা দেখায়, স্থানীয় ইনফারেন্স আর শখের মানুষের আপস নয়, বরং অর্থের বিনিময়ে পাওয়া API-র কার্যকর বিকল্প।
হার্ডওয়্যার কেনার সময় দ্রুত ফুরিয়ে আসছে। দুই দশকের মধ্যে মেমরির দাম এখন সবচেয়ে খারাপ পর্যায়ে, আর তা গ্রাফিক্স কার্ডের দামও বাড়াচ্ছে।
এই নিবন্ধে বেঞ্চমার্কের ফল, দুই মডেলের ভেতরের পার্থক্য, ওপেন মডেল কোথায় এখনও পিছিয়ে, এবং আগামী বারো মাস অপেক্ষা করার অনুপযুক্ত সময় কেন, তা তুলে ধরা হয়েছে।
আপনার ফলাফল: কাজের ধরন অনুযায়ী মডেল ও মেমরির স্তর বেছে নিন। কেনার আগে হার্ডওয়্যার, বিদ্যুৎ, কনটেক্সটের আকার ও মাপা থ্রুপুটের খরচ তুলনা করুন। বেঞ্চমার্ক আপনার নির্দিষ্ট কাজের মান বা ভবিষ্যৎ GPU-র দাম বলে দেয় না।
সংক্ষিপ্ত উত্তর
স্থানীয় 27B মডেল ও অর্থের বিনিময়ে পাওয়া শীর্ষস্থানীয় মডেলের কাছাকাছি API-র বুদ্ধিমত্তার ব্যবধান মুছে গেছে। দামি মডেলের বাকি সুবিধাগুলো দামের পার্থক্যের তুলনায় সীমিত।
একসঙ্গে তিনটি পরিবর্তন হয়েছে:
- ওপেন 27B মডেল শীর্ষস্থানীয় ফলের কাছাকাছি পৌঁছেছে। একই মূল্যায়ন পদ্ধতিতে Qwen3.8 27B-এর Intelligence Index 33.7, Sonnet 4.6-এর 30.1।
- টার্নারি কোয়ান্টাইজেশন মেমরির চাহিদা প্রায় দুই-তৃতীয়াংশ কমিয়েছে। Bonsai 2 27B পুরো 27B মডেলটি 5.53 GiB-তে চালায়, যা কয়েকশ ডলারের কার্ডেও ধরে।
- মেমরির সরবরাহ খারাপ হয়েছে। ২০২৬ সালের শুরুর দিকে প্রচলিত DRAM-এর চুক্তিমূল্য আগের প্রান্তিকের তুলনায় 90 থেকে 95 শতাংশ বেড়েছে। TrendForce-এর রেকর্ডে এটি সবচেয়ে বড় ত্রৈমাসিক বৃদ্ধি, আর পরবর্তী প্রজন্মের GPU 2028-এ পিছিয়েছে।
এখন কেনা বা তৈরি করাই কম খরচের পথ। এটি বিক্রির কথা নয়, সরবরাহের তথ্যের কথা।
এক-GPU পরীক্ষা দেখুন
উপরের দাবির জন্য টেবিলের বদলে প্রদর্শন দরকার। Bijan Bowen একটি GPU-র কম্পিউটারে Bonsai 2 27B পরীক্ষা করে জানতে চেয়েছেন, এটি এখন একটি কার্ডের জন্য সেরা মডেল কি না।
টোকেন-প্রতি-সেকেন্ডের বদলে উত্তরের মান দেখুন। গতি ঠিক করাই সহজ।
দুই নাম, এক মডেল
এখানে বোঝার মতো দুই মডেল প্রতিদ্বন্দ্বী নয়। দুইটিতেই একই ওয়েট, তবে নির্ভুলতার মাত্রা আলাদা।
| Qwen3.8 27B | টার্নারি Bonsai 2 27B | |
|---|---|---|
| কী এটি | Qwen-এর মূল ওপেন-ওয়েট মডেল | Prism ML-এর তৈরি Qwen3.8-27B-এর টার্নারি পুনঃপ্যাক |
| ডিস্কে ওয়েট | 18 GB | 5.53 GiB (PTQ1_0) অথবা 6.70 GiB (PQ2_0) |
| প্যারামিটার | 27B ঘন | 26.90B, একই স্থাপত্য |
| কনটেক্সট | 256K | 262,144 টোকেন |
| ভিশন | আছে, নেটিভ | আছে, আলাদা CLIP প্রজেক্টর প্যাক |
| টুল কলিং | আছে | আছে |
| লাইসেন্স | Apache 2.0 | Apache 2.0 |
| রানটাইম | Ollama, llama.cpp, MLX | শুধু Prism ML-এর llama.cpp fork |
qwen3.8-এর Ollama লাইব্রেরি পাতায় 27B মডেলের আকার 18 GB, 256K কনটেক্সট, ভিশন ও টুল কলিং সমর্থন, এবং Apple Silicon-এর জন্য আলাদা MLX বিল্ড উল্লেখ আছে। Ollama-র টার্নারি সংস্করণটি Prism ML-এর Apache-2.0 GGUF প্যাকের মিরর, একই checksum দিয়ে পুনঃপ্রকাশ করা হয়েছে।
ব্যবহারিক প্রশ্নটি কোন মডেল নেবেন, তা নয়। একই বুদ্ধিমত্তার জন্য কত মেমরি খরচ করবেন, সেটি। টার্নারি সংস্করণে প্রায় এক-তৃতীয়াংশ মেমরি লাগে এবং ত্যাগ সামান্য।
বেঞ্চমার্কের তুলনা
Artificial Analysis দুই মডেলকে একই পরীক্ষায় নম্বর দেয়। সারাংশের বদলে প্রতিটি সারি পড়ুন, কারণ দুই মডেল আলাদা ক্ষেত্রে এগিয়ে।
| বেঞ্চমার্ক | Qwen3.8 27B | Claude Sonnet 4.6 | এগিয়ে |
|---|---|---|---|
| Intelligence Index | 33.7 | 30.1 | ওপেন |
| Coding Index | 68.1 | 63.0 | ওপেন |
| Agentic Index | 45.8 | 31.8 | ওপেন |
| GPQA Diamond | 90.5% | 87.5% | ওপেন |
| Humanity’s Last Exam | 33.9% | 33.6% | ওপেন |
| AA-LCR (দীর্ঘ কনটেক্সট) | 82.0% | 80.0% | ওপেন |
| GDPval-AA | 45.4% | 36.0% | ওপেন |
| CritPt (গবেষণা পদার্থবিজ্ঞান) | 5.4% | 3.1% | ওপেন |
| হ্যালুসিনেশন-বিহীন হার | 69.7% | 51.6% | ওপেন |
| SciCode | 46.6% | 50.1% | Sonnet |
| AA-Omniscience নির্ভুলতা | 15.6% | 40.9% | Sonnet |
তুলনাযোগ্য এগারোটি সারির মধ্যে ওপেন মডেল নয়টিতে এগিয়ে, সব সামগ্রিক সূচকসহ।
ওপেন মডেল কোথায় এগিয়ে
তিনটি সামগ্রিক সূচকই মূল ফল তুলে ধরে। Intelligence 33.7 বনাম 30.1, Coding 68.1 বনাম 63.0, Agentic 45.8 বনাম 31.8। এজেন্ট সূচকে ব্যবধান সবচেয়ে বড়। একক প্রম্পটের বদলে যারা স্বয়ংক্রিয় বহু-ধাপের কাজ চালান, তাদের জন্য এটি বেশি গুরুত্বপূর্ণ।
শতকরা অবস্থান হিসেবে Artificial Analysis-এ Qwen3.8 27B এজেন্ট সূচকে 86 শতাংশ মডেলের চেয়ে ভালো, আর কোডিংয়ে 76 শতাংশের চেয়ে ভালো। Sonnet 4.6 যথাক্রমে 68 ও 72 শতাংশে। স্নাতকোত্তর পর্যায়ের বিজ্ঞান-যুক্তিতে ওপেন মডেল GPQA Diamond-এ 90.5 শতাংশ পেয়েছে।
Sonnet 4.6 কোথায় এগিয়ে
দুটি ফল উল্টো, আর কোনোটিই তুচ্ছ নয়।
AA-Omniscience মাপে, জ্ঞানভিত্তিক প্রশ্নে মডেল প্রথমবারেই সঠিক উত্তর দেয় কি না। Sonnet 4.6-এর ফল 40.9 শতাংশ, বিপরীতে 15.6 শতাংশ। তথ্যের নির্ভরযোগ্যতায় ব্যবধানটি বড় এবং দামি মডেলের পক্ষে সবচেয়ে জোরালো একক যুক্তি।
হ্যালুসিনেশন-বিহীন সারিটি সতর্কভাবে পড়তে হবে। Qwen-এর 69.7 শতাংশ বনাম Sonnet-এর 51.6 শতাংশ স্পষ্ট জয় মনে হয়, এবং একা দেখলে তা-ই। কিন্তু এই মেট্রিকটি ভুল উত্তরের মধ্যে কত ভাগে মিথ্যা তথ্য তৈরি হয়নি তা বোঝায়। কম নির্ভুল মডেল বেশি ভুল উত্তর দেয়, তাই শতাংশগুলো আলাদা গোষ্ঠী মাপে এবং সরাসরি তুলনা করা যায় না। আগে নির্ভুলতার সারি পড়ুন।
SciCode-এ Sonnet 50.1 শতাংশ বনাম 46.6 শতাংশ পেয়েছে। ওপেন মডেলের কার্ডে নেই, এমন দুই মূল্যায়ন IFBench ও Terminal-Bench Hard-এর ফলও Sonnet প্রকাশ করে। এগুলোর তুলনা সম্ভব নয়।
দুটি সৎ সতর্কতা
প্রকাশের তারিখে ছয় মাসের ব্যবধান। Sonnet 4.6 এসেছে ফেব্রুয়ারি 2026-এ, Qwen3.8 27B এসেছে আগস্ট 2026-এ। ফেব্রুয়ারির শীর্ষ মডেলের সঙ্গে আগস্টের ওপেন মডেলের তুলনা সমান প্রতিযোগিতা নয়।
Sonnet 4.6 আর Anthropic-এর শীর্ষ মডেল নয়। Sonnet 5 ও Opus 5 এখন পণ্যের তালিকায় এর ওপরে। ওপেন 27B 2026-এর মাঝামাঝি সময়ের শীর্ষ মডেলকে ছুঁয়েছে, বর্তমান সেরাটিকে নয়। বিপরীত দাবি করলে টেবিল থেকে অতিরিক্ত সিদ্ধান্ত টানা হয়।
বেঞ্চমার্ক বেঞ্চমার্কের ফল মাপে। আপনার নিজের কাজের ফলই গুরুত্বপূর্ণ।
টার্নারি ওয়েটে কী বদলায়
Bonsai 2 ছোট মডেল নয়। এটি অনেক কম সংখ্যাগত নির্ভুলতায় একই 26.90B মডেল। প্রকাশিত GGUF metadata-তে এই বিনিময় স্পষ্ট।
| বৈশিষ্ট্য | মান |
|---|---|
| স্থাপত্য | qwen35, প্রতি চতুর্থ স্তরে পূর্ণ attention-সহ hybrid attention, সঙ্গে state-space স্তর |
| প্যারামিটার | 26.90B |
| ব্লক | 64 |
| Embedding-এর প্রস্থ | 5120 |
| Attention | 24টি query head, 4টি KV head, key/value দৈর্ঘ্য 256 |
| কনটেক্সট | 262,144 টোকেন, RoPE base 1e7 |
| ওয়েট ফরম্যাট | টার্নারি, group size 128। প্রতি ওয়েটে PQ2_0 2.13 bit, PTQ1_0 1.75 |
| ভিশন টাওয়ার | CLIP, 460.73M প্যারামিটার, আলাদা projector pack-এ বিতরণ করা |
| লাইসেন্স | Apache 2.0 |
টার্নারি ওয়েটে প্রতিটি প্যারামিটার ষোলোটির বদলে তিনটি মানের একটি নেয়। এই সংকোচনই মূল বিষয়, এবং তাই পূর্ণ 27B মডেল 18 GB-এর বদলে 5.53 GiB-তে ধরে।
মাপা থ্রুপুট
32 GB RTX 5090-এ llama-bench দিয়ে মাপা হয়েছে। সব স্তর GPU-তে, flash attention চালু, তিনবার চালানোর গড়:
| প্যাক | ওয়েট | Prefill (pp512) | Decode (tg128) |
|---|---|---|---|
| PQ2_0 | 6.70 GiB | 3802.74 tok/s | 135.41 tok/s |
| PTQ1_0 | 5.53 GiB | 1876.31 tok/s | 131.41 tok/s |
PQ2_0-এর prefill PTQ1_0-এর চেয়ে 2.03 গুণ দ্রুত, আর decode পরিসংখ্যানগতভাবে সমান। তাই PQ2_0 যুক্তিযুক্ত ডিফল্ট। শেষ 1.2 GiB মেমরি গুরুত্বপূর্ণ হলেই PTQ1_0 নিন। 65K কনটেক্সটে llama-server দিয়ে একক streaming request-এ decode 136.5 tok/s ছিল।
দৈনন্দিন ব্যবহারে decode-এর গতিটাই টের পাবেন। প্রতি সেকেন্ডে 135 টোকেন পড়ার গতিকে ছাড়িয়ে যায়। স্থানীয় ইনফারেন্স চালানোর কারণ কম latency নয়, কারণ হোস্টেড API যথেষ্ট দ্রুত। কারণ হলো খরচ, গোপনীয়তা এবং নিয়ন্ত্রণ।
যে বাধার কথা কেউ বলে না
সাধারণ Ollama এই ফাইল লোড করতে পারে না। টার্নারি kernel আছে Prism ML-এর llama.cpp fork-এ। Ollama 0.34.2-এ যাচাই করলে load ব্যর্থ হয়ে unsupported tensor "output.weight" size overflows বার্তা দেয়। Runtime qwen35 স্থাপত্য চেনে, কিন্তু লাইব্রেরিতে কোথাও pq2_0 বা ptq1_0 নেই, Hadamard activation runtime-ও নেই।
আরেকটি সমস্যা আগে জানা দরকার। এই পরিবারের F16 pack নিরাপদ fallback মনে হলেও তা নয়। সাধারণ F16 ও F32 tensor হওয়ায় এটি parse ও load হয়, কিন্তু পরে অসংলগ্ন লেখা decode করে। prism.hadamard.* metadata-তে বলা rotated basis-এ ওয়েট রাখা হয়েছে। Runtime-কে মিল থাকা rotation প্রয়োগ করতে হবে, নইলে অর্থহীন আউটপুট হবে। 50.1 GiB F16 pack-টি 32 GB কার্ডে পুরোপুরি offload-ও হবে না।
ডাউনলোডের আগে model card পড়ুন। কমিউনিটি mirror সমর্থিত বিল্ড নয়, আর পাতায় বিষয়টি স্পষ্ট বলা আছে।
পেছনে থাকা MoE ঢেউ
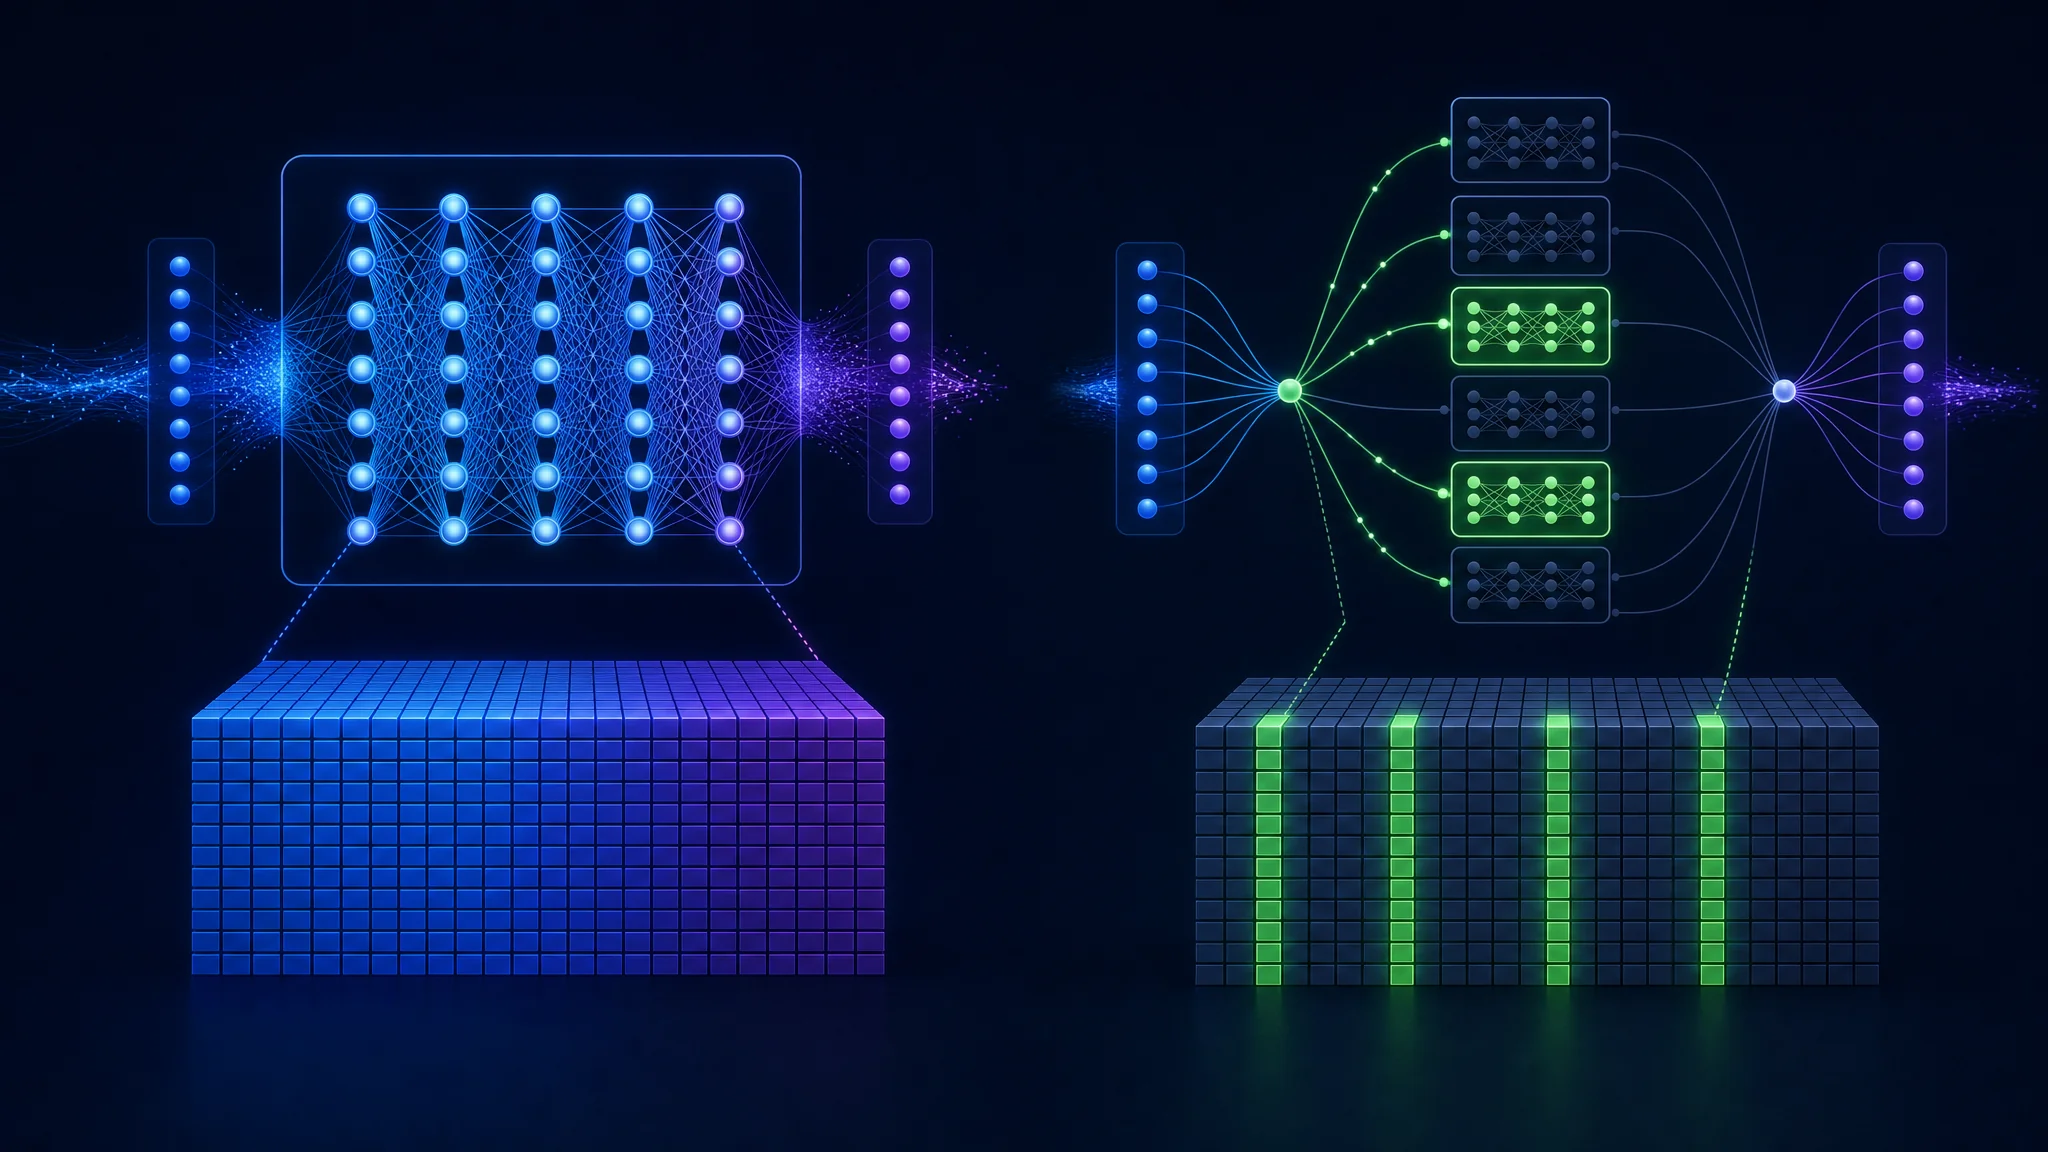
ঘন 27B মডেল গল্পের অর্ধেক। Mixture-of-experts মডেল প্রতি টোকেনে প্যারামিটারের ছোট অংশ সক্রিয় করে, যা হিসাব আবার বদলে দেয়।
| মডেল | মোট / সক্রিয় | কনটেক্সট | নোট |
|---|---|---|---|
| Qwen3.8 2.4T A95B | 2.4T / 95B | 1.0M | Qwen3.8 Max-এর ওপেন-ওয়েট সহযোগী |
| Qwen3.6 35B A3B | 35B / 3B | 262K | Apache 2.0, hybrid sparse MoE |
| Qwen3 Coder Next | 80B / 3B | 256K | সবসময় চালু coding agent-এর জন্য ওপেন ওয়েট |
স্থানীয় কাজের জন্য Qwen3 Coder Next নজরে রাখুন। মোট 80B প্যারামিটারের মধ্যে প্রতি টোকেনে 3B সক্রিয় হয়। CLI ও IDE পরিবেশে সবসময় চলা agent-এর জন্য এটি তৈরি। 3B সক্রিয় করা মডেল 3B মডেলের গতিতে লেখা তৈরি করে, অথচ 80B-এর সঞ্চিত ক্ষমতা কাজে লাগায়। মূল নোটে বলা হয়েছে, সক্রিয় কম্পিউটের 10 থেকে 20 গুণ বেশি ব্যবহার করা মডেলের সঙ্গে এর পারফরম্যান্স তুলনীয়।
ঘন 27B আজ নিরাপদ পছন্দ। দক্ষতার রেখা এখনও বদলাচ্ছে sparse মডেলে।
হার্ডওয়্যার কেনার সুযোগ শেষ হচ্ছে
এই গল্পের সঙ্গে সময়সীমা জুড়ে থাকা অংশ এটি।
স্থানীয় ইনফারেন্স সস্তা হয়েছে ঠিক তখনই, যখন এর জন্য দরকারি মেমরি দামি হতে শুরু করেছে। দুই প্রবণতা সংঘর্ষের দিকে যাচ্ছে, আর খুচরা দামে তার প্রভাব দেখা যাচ্ছে।
মেমরির দামে কী ঘটেছে
2026 সালের প্রথম প্রান্তিকে প্রচলিত DRAM-এর চুক্তিমূল্য আগের প্রান্তিকের তুলনায় 90 থেকে 95 শতাংশ বেড়েছে, TrendForce-এর রেকর্ডে এটিই সর্বোচ্চ ত্রৈমাসিক বৃদ্ধি। একই সময়ে NAND flash 55 থেকে 60 শতাংশ বেড়েছে।
চাপ কমেনি। TrendForce-এর তথ্য অনুযায়ী দ্বিতীয় প্রান্তিকে DRAM আরও 58 থেকে 63 শতাংশ এবং NAND 70 থেকে 75 শতাংশ বেড়েছে। তৃতীয় প্রান্তিকের ধীর বৃদ্ধি, DRAM 13 থেকে 18 শতাংশ এবং NAND 10 থেকে 15 শতাংশ, ছাড় নয়; বরং রেকর্ড দুই প্রান্তিকের সঙ্গে মুদ্রাস্ফীতি যোগ করছে।
কারণটি কাঠামোগত, সাময়িক চক্র নয়। AI data center-এর নির্মাণ ফোন, laptop ও game console-কে সরবরাহ করা মেমরি শুষে নিচ্ছে, আর মেমরি নির্মাতারা বেশি মুনাফার অর্ডার আগে নেয়। মডিউল সরবরাহ পর্যবেক্ষণকারী বিশ্লেষকদের ধারণা, 2027-এ মডিউল নির্মাতাদের DRAM chip সরবরাহ 70 শতাংশেরও বেশি কমবে।
Intel-এর প্রধান নির্বাহী সমস্যাটির পরিমাণ বলেছেন। 15 সেপ্টেম্বর 2026-এ Santa Clara-র AI Infrastructure Summit-এ Lip-Bu Tan বলেন, মেমরির দাম আগের স্তরের তুলনায় ইতিমধ্যে “পাঁচ, ছয়, সাত গুণ” বেড়েছে। তিনি সতর্ক করেন, কম দামের laptop-এর bill of materials-এর 70 থেকে 80 শতাংশ এখন শুধু মেমরির পেছনে যায়। অন্য সময়ে তিনি বলেছেন, 2028-এর আগে স্বস্তি নেই।
DRAM ও আধুনিক logic wafer-এর প্রতি এলাকার দামের তুলনা নিয়ে স্বাধীন প্রতিবেদনে একটি গুরুত্বপূর্ণ সতর্কতা আছে। Spot price চুক্তিমূল্য নয়, আর DDR5 spot কেনাকাটা এত সীমিত যে তুলনাটি ইঙ্গিত দেয়, নিশ্চিত সিদ্ধান্ত নয়। তবে দামের দিক নিয়ে সন্দেহ নেই।
গ্রাফিক্স কার্ডের ওপর প্রভাব
গ্রাফিক্স কার্ডের উপাদান ব্যয়ের বড় অংশ মেমরি। তাই DRAM-এর দাম সরাসরি GPU-র দামে প্রভাব ফেলে।
| কার্ড | 2025-এর শুরু | সেপ্টেম্বর 2026 |
|---|---|---|
| Nvidia RTX 5090 | $1,999 | $5,000-এর বেশি |
| Asus RTX 5080 | $1,199 | $1,595 |
| AMD RX 9070 XT | প্রায় $830 | $1,037-এর বেশি |
2026-এ এই দামগুলো বিচ্ছিন্ন লাফ হিসেবে নয়, সমন্বিত কয়েক দফায় বেড়েছে। Nvidia জানুয়ারিতে দাম বাড়ায়, মে মাসে বিশেষভাবে RTX 5090-এর দাম বাড়ায়, এবং বছরের শেষভাগে আবার বাড়ায়। আগস্টে AMD নির্বাচিত Radeon কার্ড ও GDDR6 মেমরি কিটে অন্তত 10 শতাংশ বৃদ্ধি করে, কারণ হিসেবে সরাসরি মেমরির খরচ জানায়।
পরবর্তী প্রজন্ম বাজারে আসেনি, পিছিয়েছে। মেমরির অপ্রাপ্যতার কারণে Nvidia-র RTX 60 সিরিজ এখন 2028-এ প্রত্যাশিত, ফলে 2027 পুরো বাদ পড়ছে।
আজকের কার্ডটি আগামী বছরের সস্তা কার্ডের সঙ্গে প্রতিযোগিতা করছে না। প্রতিযোগিতা হচ্ছে একই কার্ডের আরও দামি সংস্করণের সঙ্গে।
অপেক্ষা করাই কেন বেশি ব্যয়বহুল
হার্ডওয়্যারের প্রচলিত পরামর্শ হলো পরবর্তী প্রজন্মের জন্য অপেক্ষা করা। মেমরির সরবরাহ সীমিত থাকলে এই পরামর্শ আপনার বিপক্ষে কাজ করে।
তিনটি বিষয় যুক্তিটিকে সমর্থন করে।
দাম ইতিমধ্যে বেড়েছে, আরও বাড়ছে। এক প্রান্তিকে DRAM-এর চুক্তিমূল্য 90 থেকে 95 শতাংশ বাড়া এমন ক্ষণস্থায়ী পরিবর্তন নয়, যা পরের প্রান্তিকে উল্টে যাবে। TrendForce তৃতীয় প্রান্তিকে আরও বৃদ্ধির পূর্বাভাস দিয়েছে, পতনের নয়, আর Intel-এর CEO স্বস্তির সময় 2028 বলেছেন।
2027-এ অপেক্ষা করার মতো পণ্য নেই। পরবর্তী প্রজন্মের ভোক্তা GPU 2028-এ পিছোলে অপেক্ষার কৌশল দুই বছর দীর্ঘ হয়। হার্ডওয়্যার বদলের প্রায় পুরো চক্রই তখন কিছু না পেয়ে কেটে যায়।
মডেলগুলো এখনই যথেষ্ট ভালো। 2026-এ এই দিকটি বদলেছে। দুই বছর আগে স্থানীয় হার্ডওয়্যারে স্পষ্টত খারাপ অভিজ্ঞতা হতো। এখন একই টাকায় 135 টোকেন/সেকেন্ডে 27B মডেল এবং 262K কনটেক্সট চলে, যা সামগ্রিক বুদ্ধিমত্তা সূচকে একটি প্রিমিয়াম API মডেলকে ছাড়ায়।
স্থানীয় মডেল ভালো হওয়ার অপেক্ষায় থাকলে, অপেক্ষা শেষ। হার্ডওয়্যারের দাম কমার অপেক্ষা করলে, সরবরাহের তথ্য বলছে 2028 পর্যন্ত অপেক্ষা করবেন।
কী তৈরি করবেন
টার্নারি ওয়েটের কারণে চাহিদা কমেছে, তাই উপরের মডেল অনুযায়ী হার্ডওয়্যার মেলানো সহজ।
| স্তর | মেমরি | স্বচ্ছন্দে কী চালাবে |
|---|---|---|
| প্রবেশ | 8 থেকে 12 GB VRAM | 5.53 থেকে 6.70 GiB টার্নারি 27B, কনটেক্সটের জন্য অতিরিক্ত জায়গাসহ |
| ব্যবহারিক | 16 থেকে 24 GB VRAM | পুরো 18 GB Qwen3.8 27B, অথবা দীর্ঘ কনটেক্সটে টার্নারি প্যাক |
| স্বচ্ছন্দ | 32 GB VRAM | পুরো 262K কনটেক্সটে টার্নারি 27B, অথবা 3B সক্রিয় 80B MoE |
| একীভূত মেমরি | 64 থেকে 128 GB | Apple Silicon বা একীভূত মেমরির desktop-এ বড় sparse MoE মডেল |
কয়েকটি ব্যবহারিক বিষয় স্তরের টেবিলের চেয়েও বেশি গুরুত্বপূর্ণ:
- ফ্ল্যাগশিপ GPU নয়, মেমরি কিনুন। 5.53 GiB টার্নারি প্যাক প্রবেশ স্তরকেও কার্যকর করে। 2026-এর দামে দামী GPU-র পেছনে ছোটা থেকে সিস্টেম RAM ও স্টোরেজে টাকা খরচ করা বেশি লাভজনক।
- একীভূত মেমরির সিস্টেম সাশ্রয়ী। 64 GB বা তার বেশি shared memory-র কম্পিউটার একই ধারণক্ষমতার আলাদা কার্ডের তুলনায় অনেক কম খরচে বড় sparse মডেল চালায়।
- বিদ্যুৎ ও শীতলীকরণ জরুরি। ঘণ্টার পর ঘণ্টা ইনফারেন্স চালানো যন্ত্র কয়েক মিনিট বেঞ্চমার্ক চালানো যন্ত্রের মতো আচরণ করে না।
- ছোট মডেলের পাশে টার্নারি প্যাক চালান। দ্রুত প্রশ্নের উত্তর 3B মডেল দেবে, কঠিন প্রশ্ন 27B সামলাবে।
প্রিমিয়াম মডেলের দাম এখনও কখন যুক্তিযুক্ত
প্রিমিয়াম স্তরের পক্ষে যুক্তি আছে, তবে বিজ্ঞাপনের তুলনায় তা সংকীর্ণ।
সৎ উত্তরটি তথ্যের নির্ভরযোগ্যতা। AA-Omniscience-এ Sonnet 4.6-এর নির্ভুলতা 40.9 শতাংশ, ওপেন 27B মডেলের 15.6 শতাংশ। ভুল উত্তর ক্লায়েন্ট, রোগনির্ণয় বা আইনি অবস্থানের ক্ষতি করলে 25 পয়েন্টের নির্ভুলতার ব্যবধান যেকোনো সামগ্রিক সূচকের চেয়ে বেশি গুরুত্বপূর্ণ।
দীর্ঘ এজেন্ট-ধারাবাহিকতা দ্বিতীয় কারণ। Terminal-Bench Hard-এ Sonnet 4.6-এর ফল 53.0 শতাংশ, τ²-Bench Telecom-এ 75.7 শতাংশ। এগুলো দীর্ঘস্থায়ী tool use ও বহু-ধাপের এজেন্ট আচরণ মাপে। ওপেন মডেলের কার্ডে তুলনীয় ফল নেই, আর এই অনুপস্থিতি উৎসাহজনক নয়।
তৃতীয় কারণ পরিচালনাগত। হোস্টেড API-তে driver update, কোয়ান্টাইজেশনের জটিলতা, llama.cpp-এর fork অনুসরণ বা ঘোরানো weight basis ঠিক করার দরকার হয় না। অন্য কেউ uptime দেখে, রাত 3টায় pager পায়।
যে প্রশ্নটি করা উচিত
তাহলে বড় প্রতিষ্ঠানের বাইরে প্রিমিয়াম স্তরের অবস্থান কোথায়?
জ্ঞান-নির্ভর কাজে এটি এখনও যুক্তিযুক্ত। গবেষণা, আইনি বিশ্লেষণ, চিকিৎসাবিষয়ক প্রশ্ন, আর্থিক মডেল এবং যেখানে আত্মবিশ্বাসী ভুল উত্তরের দাম বেশি। এমন কাজ সত্যিই আছে, এবং নির্ভুলতার ব্যবধান অর্থ দেওয়ার বাস্তব কারণ।
সৃজনশীল কাজের ক্ষেত্রে যুক্তি দ্রুত কমছে। খসড়া, সারাংশ, কোড পুনর্গঠন, ডেটা পুনর্বিন্যাস, নথি শ্রেণিবিন্যাস এবং স্বয়ংক্রিয় pipeline—সব ক্ষেত্রেই ফল বিশ্বাসের আগে যাচাই করা হয়। মানুষ বা test suite আগে যাচাই করলে নির্ভুলতার ব্যবধানের ক্ষতি সামান্য। এমন কাজে, আপনার নিজের হার্ডওয়্যারে 33.7 সূচকের মডেল বিনা অতিরিক্ত খরচে চলে, অথচ 30.1 সূচকের জন্য প্রতি token-এ অর্থ দেওয়া কঠিন যুক্তি।
সিদ্ধান্ত এখন সক্ষমতা থেকে পরিণতিতে সরে গেছে। দুই বছর আগে প্রশ্ন ছিল, স্থানীয় মডেল আদৌ কাজ করতে পারে কি না। আজ প্রশ্ন হলো ভুলের খরচ কত এবং কীভাবে তা ধরবেন।
প্রতিষ্ঠানের বাড়তি খরচে নির্ভরযোগ্যতা, compliance এবং অন্য কারও on-call দায়িত্ব কেনা হয়। অন্যরা এমন পার্থক্যের জন্য অর্থ দেয়, যা test suite চললেই আর গুরুত্ব পায় না।
মূল কথা
- স্থানীয় 27B মডেল সামগ্রিক বুদ্ধিমত্তা সূচকে এখন Claude Sonnet 4.6-কে ছাড়ায়, 33.7 বনাম 30.1, এবং কোডিং, এজেন্ট কাজ, দীর্ঘ কনটেক্সট ও স্নাতকোত্তর স্তরের বিজ্ঞান-যুক্তিতে এগিয়ে।
- Sonnet 4.6 এখনও তথ্যের নির্ভুলতায় জেতে, AA-Omniscience-এ 40.9 বনাম 15.6 শতাংশ, যা প্রিমিয়াম স্তরের সবচেয়ে শক্তিশালী অবশিষ্ট যুক্তি।
- টার্নারি কোয়ান্টাইজেশন ব্যবহারিক পরিবর্তনটি এনেছে। Bonsai 2 27B একই 26.90B মডেল 18 GB-এর বদলে 5.53 GiB-তে চালায়, আর দুটির লাইসেন্স Apache 2.0।
- সাধারণ Ollama টার্নারি প্যাক চালাতে পারে না। Prism ML-এর llama.cpp fork দরকার, আর F16 fallback ব্যর্থ না হয়ে নীরবে অসংলগ্ন আউটপুট দেয়।
- RTX 5090-এ decode-এর মাপা গতি প্রতি সেকেন্ডে 135 টোকেন, যা পড়ার গতির চেয়ে অনেক বেশি।
- মেমরির দাম এখন পদক্ষেপ নেওয়ার কারণ। 2026-এ এক প্রান্তিকে DRAM-এর চুক্তিমূল্য 90 থেকে 95 শতাংশ বেড়েছে, আর পরবর্তী প্রজন্মের ভোক্তা GPU 2028-এ পিছিয়েছে।
- RTX 5090-এর দাম $1,999 থেকে বেড়ে $5,000-এর বেশি হয়েছে দুই বছরেরও কম সময়ে, বাকি স্তরগুলোও তার সঙ্গে বেড়েছে।
পরবর্তী পদক্ষেপ
- মডেলটি ডাউনলোড করে নিজের কাজের সঙ্গে পরীক্ষা করুন: Ollama-তে Ternary Bonsai 2 27B
- মেমরি থাকলে পুরো নির্ভুলতায় মূল ওয়েট নিন: Ollama-তে Qwen3.8
- কিছু তৈরি করার আগে বিনা মূল্যের হোস্টেড endpoint-এ মডেলটি চেষ্টা করুন: OpenRouter-এ বিনা মূল্যে Qwen3.8 27B
- একই prompt-এ অর্থের বিনিময়ে পাওয়া সংস্করণের সঙ্গে তুলনা করুন: OpenRouter-এ Claude Sonnet 4.6
- উপরের মেমরি টেবিল ধরে প্রয়োজনীয় স্তরের কম্পিউটার ঠিক করুন, এবং গ্রাফিক্স কার্ডের আগে মেমরি কিনুন।
- অব্যবহৃত Raspberry Pi থাকলে ছোট মডেল চালাতে পারে কি না দেখুন: Raspberry Pi 4 বা 5-এ কোন AI মডেল চলে?
সম্পর্কিত নিবন্ধ
| নিবন্ধ | কী আছে |
|---|---|
| Raspberry Pi 4 বা 5-এ কোন AI মডেল চলে? | স্থানীয় ইনফারেন্সের নিম্ন সীমা এবং ছোট বোর্ড বাস্তবে কী চালাতে পারে |
| Meshtastic-এর জন্য গোপনীয়তা-রক্ষাকারী AI সহকারী তৈরি | নেটওয়ার্কবিহীন হার্ডওয়্যারে স্থানীয় সহকারী, যেখানে গোপনীয়তা ঐচ্ছিক নয় |
| ডেটা বিকৃতি ঠেকাতে ECC মেমরির ভূমিকা | বড় মডেল মেমরিতে থাকলে মেমরির মান কেন বেশি গুরুত্বপূর্ণ |
| হোম ল্যাব কী, এবং আপনার কি এটি থাকা উচিত? | গরম হয় এমন হার্ডওয়্যারের জন্য জায়গা, বিদ্যুৎ ও শীতলীকরণ পরিকল্পনা |
সূত্র
- Ternary Bonsai 2 27B - Ollama মডেল মিরর
- Qwen3.8 - Ollama মডেল লাইব্রেরি
- Qwen3.8 27B (বিনা মূল্যে) - OpenRouter বেঞ্চমার্ক ও মূল্য
- Claude Sonnet 4.6 - OpenRouter বেঞ্চমার্ক ও মূল্য
- Bonsai 2 27B-এর প্রথম পরীক্ষা: এটি কি এক-GPU-র সেরা AI মডেল? - Bijan Bowen
- Artificial Analysis - মডেলের স্বাধীন মূল্যায়ন
- TrendForce - DRAM ও NAND-এর চুক্তিমূল্যের পূর্বাভাস
- এখন প্রতি এলাকার হিসাবে মেমরি চিপের দাম কম্পিউট চিপের চেয়ে বেশি - Tom’s Hardware
- DRAM-এর রেকর্ড 95% বৃদ্ধিতে GPU-র স্বস্তি পিছিয়ে 2028 - Tech Insider
- Intel-এর Tan: মেমরির দাম 7 গুণ বেড়েছে, 2028-এর আগে স্বস্তি নেই - shattered.io
- Prism ML-এর llama.cpp fork - টার্নারি kernel
- Ternary-Bonsai-2-27B-gguf - উৎসের ওয়েট
Related Posts
This article refers to other articles we've written:
- Raspberry Pi 4 বা 5-এ কোন AI মডেল চলে?
Raspberry Pi 4 ও 5-এর পরিমাপ করা ফল থেকে মেমরি, গতি ও কাজের ধরন অনুযায়ী স্থানীয় ভাষার মডেল বাছুন, ছোট LFM2.5 থেকে 3B ও বড় বিকল্প পর্যন্ত।
- Meshtastic-এর জন্য গোপনীয়তা-সুরক্ষিত AI সহকারী তৈরি
Meshtastic-এর জন্য স্থানীয় AI সহকারী তৈরির ব্যবহারিক অভিজ্ঞতা, যেখানে ব্যক্তিগত কনফিগারেশন, সারিবদ্ধ TCP অ্যাক্সেস, তথ্য সংগ্রহের টুল এবং আরও নিরাপদ ড্যাশবোর্ড রয়েছে।