আমাদের হাইব্রিড এজেন্টিক AI ফ্লিটের ভেতরে: Hermes, LiteLLM ও Tailscale

Table of Contents
আমরা প্রতি অনুরোধে স্থানীয় GPU বরাদ্দ করা একটি ফ্লিট চালু করেছি এবং এর হাইব্রিড control plane নকশা করেছি। যাচাইকৃত পথ LiteLLM থেকে শুরু হয়, একটি model pool বেছে নেয় এবং একবারে একটি GPU-তে স্থানীয় মডেল লোড করে। Hermes-এর tier policy প্রস্তাবিত, আর Tailscale Aperture-এর একটি configuration artifact পরবর্তী integration test-এর জন্য প্রস্তুত। কোনোটিই এখনও একক end-to-end route-এর অংশ হিসেবে যাচাই হয়নি।
নিষ্ক্রিয় কার্ডগুলো Pearl মাইন করে। AI অনুরোধ শুধু lease নেওয়া কার্ডটির mining থামায়, অনুরোধটি সেবা দেয়, মডেল unload করে এবং কার্ডটিকে miner-এ ফেরত দেয়।
মূল কথা
- T0 থেকে T2 ব্যয়বহুল বা কঠিন কাজ সামলায়। এই route-গুলো hosted frontier model এবং সাজানো fallback chain-কে অগ্রাধিকার দেয়।
- T3 গুরুত্বপূর্ণ স্থানীয় কাজ সামলায়। ফ্লিট planning, coding, review এবং vision-এর কাজ 4B থেকে 12B মডেলে দেয়।
- T4 বেশি পরিমাণের স্থানীয় কাজ সামলায়। ছোট মডেল routing, classification, extraction, embedding এবং সীমিত code task করে।
- প্রতিটি GPU স্বতন্ত্র সম্পদ। একটি কার্ড AI সেবা দেয়, অন্য কার্ডগুলো মাইনিং চালায়।
- নিষ্ক্রিয় অবস্থায় স্থানীয় মডেল unload থাকে। অনুরোধের মধ্যবর্তী সময়ে কোনো মডেল GPU memory ধরে রাখে না।
- প্রতিটি gateway একই logical catalog প্রকাশ করে। Shared alias যোগ্য সিস্টেমগুলোর মধ্যে কাজ ছড়ায়। দরকার হলে node-prefixed alias নির্দিষ্ট placement বজায় রাখে।
- পরীক্ষামূলক broker production-এ যায়নি। এর canary একটি অনুরোধ সেবা দিয়েছিল, পরে পরিষ্কার shutdown test-এ ব্যর্থ হয়। LiteLLM যাচাইকৃত request-scoped পথে থেকেছে।
- Hermes ও Aperture এখনও প্রস্তুতির পর্যায়ে। লক্ষ্য নকশা আছে, তবে end-to-end acceptance test বাকি।
পূর্বশর্ত: একাধিক Linux GPU host, স্থিতিশীল NVIDIA driver, একটি Tailscale tailnet, systemd, সচল miner, মডেল storage এবং প্রতিটি model route-এর acceptance test।
সময় ও কঠিনতা: উন্নত। inventory, model download, service definition, routing test, failure drill এবং প্রতিটি কার্ডে mining recovery check-এর জন্য কয়েক দিন রাখুন।
নিচে ব্যবহৃত শব্দ: tailnet হলো Tailscale identity ও device দিয়ে তৈরি ব্যক্তিগত network। model alias হলো client-কে দেখানো স্থিতিশীল model name। model group এক alias-এর পেছনে একাধিক deployment রাখে। pool proxy হলো ছোট স্থানীয় service, যা GPU lease নেয়, model worker চালায় এবং কার্ডটিকে mining-এ ফেরায়।
নকশার লক্ষ্য
এজেন্টের কাজ নানা রকম। repository repair-এর জন্য যে মডেল দরকার, title, screenshot, embedding বা intent label-এর জন্য একই মডেল দরকার হয় না। প্রতিটি turn সবচেয়ে বড় মডেলে পাঠালে অর্থ এবং স্থানীয় capacity নষ্ট হয়। প্রতিটি turn সবচেয়ে ছোট মডেলে পাঠালে retry বাড়ে এবং ফল দুর্বল হয়।
আমরা পাঁচটি workload band-সহ একটি catalog চেয়েছিলাম। পরিচিত API format দিয়ে hosted ও local model সেবা দেওয়ার নীতি দরকার ছিল। AI request-এর মাঝেও স্থানীয় GPU-গুলোকে কাজে রাখতে চেয়েছিলাম।
ফ্লিটের concurrency-ও দরকার ছিল। একাধিক কার্ডের host একই সময়ে কয়েকটি স্বাধীন কাজ সেবা দেবে। একটি কার্ডে আসা অনুরোধ chassis-এর সব কার্ডের mining থামাবে না।
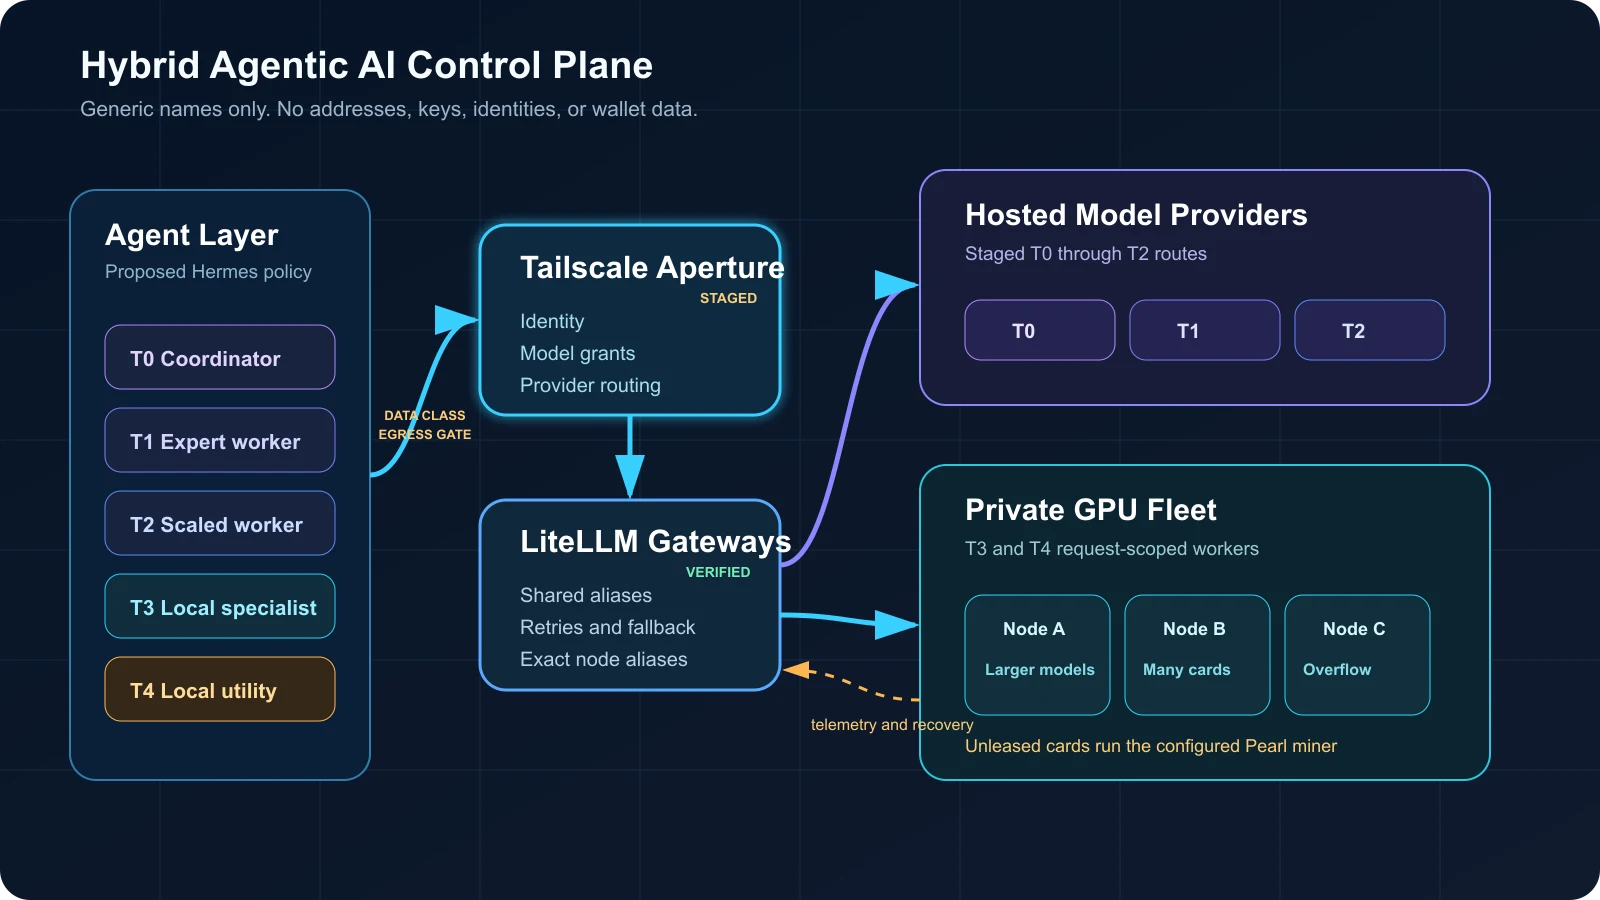
প্রস্তাবিত এবং প্রস্তুতিপর্বের control path যাচাইকৃত LiteLLM ও per-GPU execution path-এর উপরে থাকে
চিত্রে সাধারণ node name ব্যবহার করা হয়েছে। এতে ব্যক্তিগত address, user identity, access key, wallet data বা physical host label নেই।
T0 থেকে T4-এর অর্থ
Tier name আমাদের routing policy বোঝায়। এগুলো শিল্পের মানদণ্ড নয় এবং শুধু model size বর্ণনা করে না।
| স্তর | প্রধান ভূমিকা | সাধারণ গন্তব্য | ব্যর্থতার সময় করণীয় |
|---|---|---|---|
| T0 | ডিফল্ট সমন্বয়কারী ও কঠিনতম সিদ্ধান্ত | হোস্ট করা উন্নত যুক্তিভিত্তিক মডেল | ক্রমানুসারে হোস্ট করা বিকল্প শৃঙ্খল |
| T1 | উচ্চ-মূল্যের worker এজেন্ট | উচ্চ সক্ষমতার হোস্ট করা মডেলসমষ্টি | নির্ধারিত শৃঙ্খলে আবার চেষ্টা |
| T2 | সাধারণ worker pool | প্রয়োজনে উন্নীতকরণসহ দ্রুত হোস্ট করা মডেল | কঠিন কাজ T1 বা T0-তে উন্নীত করা |
| T3 | উল্লেখযোগ্য ব্যক্তিগত স্থানীয় কাজ | 4B থেকে 12B স্থানীয় চ্যাট, কোড, পর্যালোচনা ও ভিশন মডেল | যোগ্য স্থানীয় নোডে আবার চেষ্টা, তারপর সীমাবদ্ধ তথ্যের ক্ষেত্রে নিরাপদে প্রত্যাখ্যান |
| T4 | সীমিত ও ঘন ঘন স্থানীয় কাজ | 0.6B থেকে 3B স্থানীয় রাউটিং, শ্রেণিবিন্যাস, কোড ও এমবেডিং মডেল | স্থানীয় প্রতিলিপিতে আবার চেষ্টা অথবা একই তথ্যসীমার মধ্যে T3-তে যাওয়া |
Tier আগে কাজের ধরন, পরে মডেল বোঝায়। নিরাপত্তাসংবেদনশীল ছোট classification T4-এ মানায়। দীর্ঘ repository plan T3 বা তার উপরে মানায়। কঠিন architecture decision-এর prompt ছোট হলেও সেটি উঁচু tier থেকে শুরু হয়।
এই ভাগ agent economics-ও বদলায়। T4 worker বারবার হওয়া কম-ঝুঁকির রূপান্তর সামলায়। T3 worker সাধারণ code ও analysis tailnet-এর ভেতরে রাখে। কঠিন কাজ ও failure recovery-এর জন্য T0 থেকে T2 উপলভ্য থাকে।
প্রতিটি hosted fallback-এর আগে data-class gate দরকার। Public, internal এবং restricted কাজের chain আলাদা। Restricted কাজ স্থানীয় থাকে এবং ব্যর্থ হলে fail closed করে। Data boundary পেরোনো retry-এর জন্য sanitized input এবং user বা workflow-এর স্পষ্ট অনুমোদন লাগে। Hosted call-এর আগে redaction credential, repository secret, private tool output এবং sensitive retrieval content সরায়।
Hermes কীভাবে কাজের নীতি সামলাবে
Hermes হলো প্রস্তাবিত agent layer। লক্ষ্য policy model class নির্ধারণ করে, tool চালায়, কাজ delegate করে এবং স্পষ্ট fallback chain ধরে এগোয়। Hermes প্রধান মডেল, auxiliary job, delegated agent এবং task-specific fallback-এর জন্য আলাদা route নথিবদ্ধ করে। এটি base URL দিয়ে custom OpenAI-compatible endpoint-ও সমর্থন করে। দেখুন Hermes কনফিগারেশন নির্দেশিকা এবং বিকল্প provider-এর নির্দেশিকা .
আমাদের policy Hermes job-কে physical server-এর বদলে স্থিতিশীল alias-এর সঙ্গে মেলায়। যেমন:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Alias কাজের উদ্দেশ্য জানায়। কোন GPU ফাঁকা, কোন node-এ বড় কার্ড আছে, বা কোন replica health check-এ ব্যর্থ হয়েছে তা Hermes-কে জানতে হবে না। নিচের layer-গুলো এসব সিদ্ধান্ত নেয়।
কিছু কাজের জন্য এখনও নির্দিষ্ট placement দরকার। Node-prefixed model ID operator diagnostic বা benchmark-কে বেছে নেওয়া একটি system-এ পাঠায়। আলাদা Aperture grant এই alias-গুলো operator-দের মধ্যে সীমিত রাখবে। সাধারণ agent traffic shared tier alias ব্যবহার করে।
Model access agent tool-কে নিরাপদ করে না। Hermes rollout-এর জন্য least-privilege tool allowlist, isolated workspace, সীমিত credential, network egress control এবং prompt injection handling দরকার। Delegated worker-কে তার কাজের জন্য যতটুকু access দরকার, তার বেশি দেওয়া উচিত নয়।
Aperture প্রস্তুতিপর্বের পরিচয়-সীমা
Tailscale প্রতিটি service public internet-এ প্রকাশ না করেই configured gateway এবং inference host-কে যুক্ত করে। User-facing boundary ও model router হিসেবে Aperture প্রস্তুত করা হচ্ছে। এই route-এর end-to-end acceptance test এখনও বাকি। Tailscale tailnet-এ encrypted client access এবং TLS দিয়ে provider forwarding-এর বর্ণনা দিয়েছে Aperture কীভাবে কাজ করে -এ।
Aperture reachability এবং permission-কে আলাদা রাখে। এর grant default-এ deny করে। Gateway-তে পৌঁছানোর পর user বা tagged device-এর জন্য মেলানো model grant দরকার। Aperture grant-এর নির্দেশিকা additive grant model ও identity source ব্যাখ্যা করে।
Deployment-এর আগে প্রস্তুতিপর্বের Aperture configuration-এ চারটি নিয়ম থাকা উচিত:
- একটি নামযুক্ত identity admin role রাখে। সাধারণ model access থেকে administration পাওয়া যায় না।
- Provider-রা সুনির্দিষ্ট model ID তালিকাভুক্ত করে। Aperture upstream service থেকে model অনুমান করে না।
- Provider URL tailnet address নির্দেশ করে। Private node name এবং address article ও public configuration example-এর বাইরে থাকে।
- Secret service-owned file-এ থাকে। Deployment-এর আগে owner-only permission, restricted service account, rotation এবং log redaction প্রয়োগ করুন। Diagnostic output-এ LiteLLM key, tailnet address, subscription token বা wallet data কখনো দেখানো যাবে না।
Aperture incoming request path-কে প্রতিটি provider base URL-এর শেষে যোগ করে। এর
কনফিগারেশন রেফারেন্স
provider root-এ duplicate /v1 suffix না দিতে সতর্ক করে। Integration risk যথেষ্ট হওয়ায় আমরা এই বিষয়টি explicit validation check-এ রেখেছি।
Vision প্রস্তুত OpenAI Chat Completions format দিয়ে image content পাঠানোর জন্য। Embedding সরাসরি private LiteLLM endpoint ব্যবহার করে, কারণ বর্তমান Aperture self-hosted provider matrix chat format নথিবদ্ধ করে, আর আমাদের embedding path chat picker-এর বাইরে LiteLLM ও llama.cpp endpoint-এর উপর নির্ভর করে। দেখুন সমর্থিত provider ও client-এর তথ্যসূত্র .
সরাসরি embedding route-এর নিজস্ব authorization boundary দরকার। অনুমোদিত identity বা service tag-এ access সীমিত করতে LiteLLM authentication, কঠোর Tailscale grant, tailnet interface-এ service binding এবং host firewall rule একসঙ্গে কাজ করা উচিত। শুধু private address কোনো authorization policy নয়।
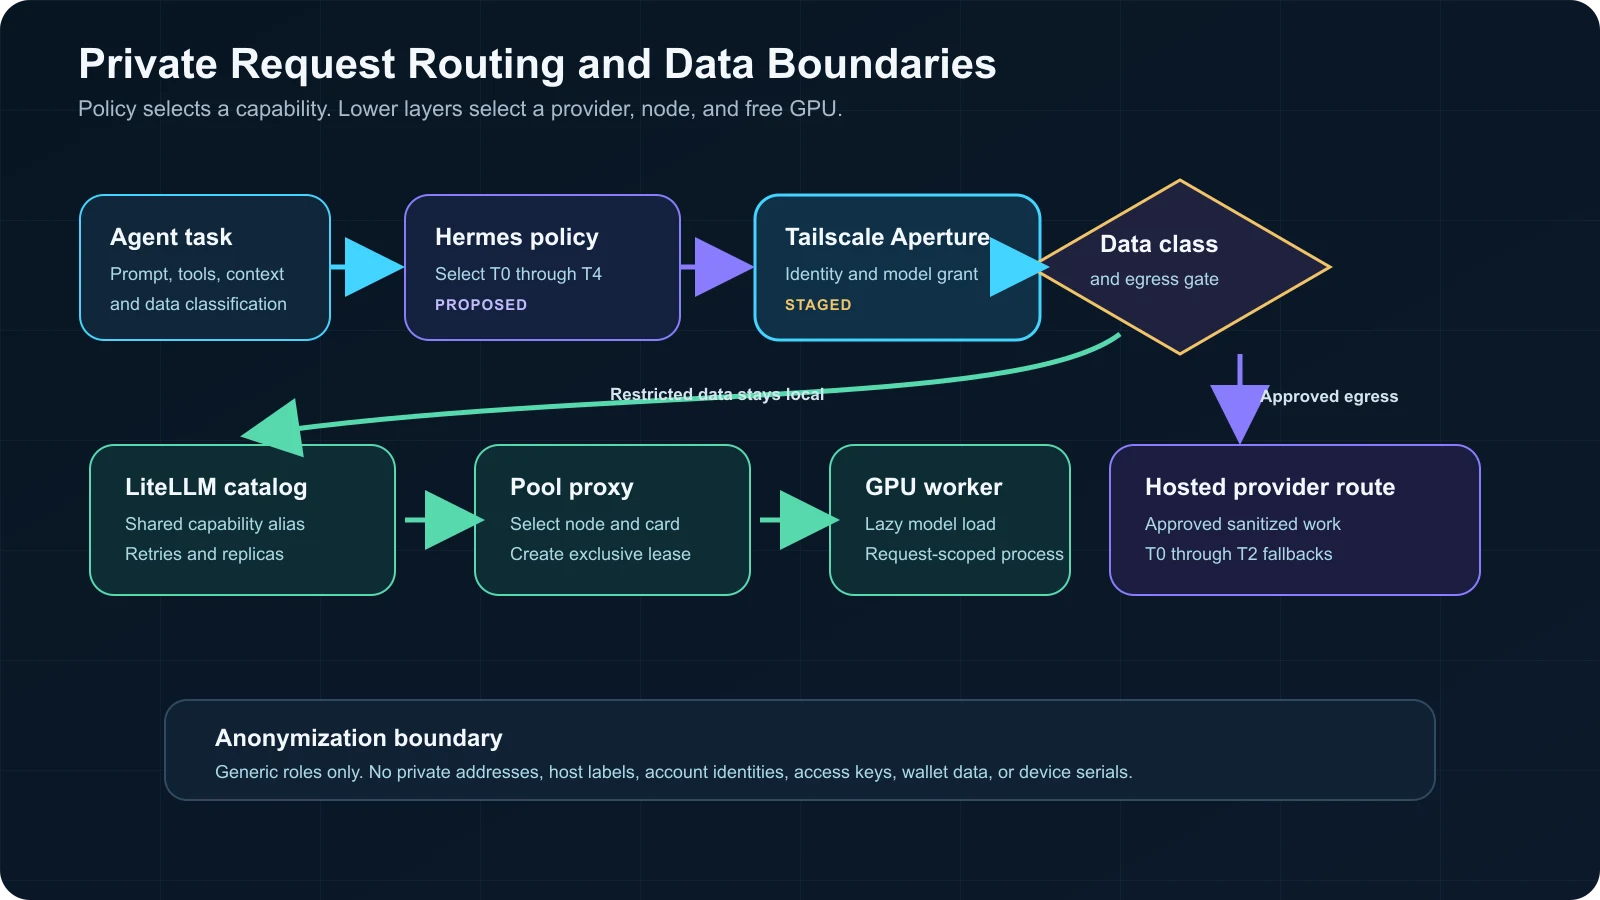
Identity, grant এবং data classification নির্ধারণ করে request private fleet ছেড়ে যাবে কি না
LiteLLM একটি তালিকা উপস্থাপন করে
প্রতিটি inference host LiteLLM gateway চালায়। Model অন্য node-এ থাকলেও প্রতিটি gateway একই logical model catalog প্রকাশ করে। Client একটি API shape এবং alias-এর একটি সেট ব্যবহার করে।
LiteLLM এক model name-এর অধীনে একাধিক deployment group করে। এরপর এর router যোগ্য deployment বেছে নেয় এবং retry, timeout, cooldown বা fallback প্রয়োগ করে। বর্তমান LiteLLM routing-এর নথি shared model name, routing strategy এবং retry behavior ব্যাখ্যা করে।
Catalog-এ দুই ধরনের address রয়েছে:
| Address style | উদাহরণ | ব্যবহার |
|---|---|---|
| Shared alias | t4-classify | যোগ্য node-গুলোর মধ্যে স্বাভাবিক কাজ ছড়ানো |
| Node alias | node-b/qwen-small | Diagnostic চালানো অথবা placement ধরে রাখা |
Shared alias Hermes না বদলেই horizontal scale দেয়। যোগ্য replica যোগ করলে model group বড় হয়। Unhealthy replica বাদ দিলে group ছোট হয়।
GPU lifecycle logic LiteLLM-এর নিচে থাকে। Gateway-এর memory footprint GPU memory reserve করে না, তাই gateway চালু থাকে। Local pool proxy নির্বাচিত model request পায়, একটি কার্ড lease নেয়, worker চালায় এবং response-এর পর worker বন্ধ করে।
স্থানীয় মডেলের তালিকা
ফ্লিট 12B parameter বা তার কম মডেলকে অগ্রাধিকার দেয়। এই সীমা উপলভ্য কার্ডের memory-এর সঙ্গে মেলে এবং context ও runtime buffer-এর জন্য জায়গা রাখে।
Model notation: B মানে বিলিয়ন parameter। K মানে configured context token-এর হাজার। Quantization কম numeric precision-এ model weight সংরক্ষণ করে memory ব্যবহার কমায়। KV cache সক্রিয় context-এর attention state ধরে রাখে এবং prompt লম্বা হলে বাড়ে। E4B ছোট Gemma 4 variant-এর জন্য Google-এর size label।
| স্তরপথ | মডেলের ধরন | নির্ধারিত প্রসঙ্গ | প্রধান কাজ | অবস্থান |
|---|---|---|---|---|
| T3 বুদ্ধিমান | Qwen3.5 9B, quantized | 64K | কঠিন স্থানীয় planning ও সাধারণ agent কাজ | বেশি memory-র GPU node |
| T3 কোড | Granite 4.2 8B, quantized | 64K | Repository কাজ, tool, terminal task, structured output | বেশি memory-র GPU node |
| T3 পর্যালোচনা | Gemma 4 12B, quantized | 32K | স্বাধীন review ও বিকল্প reasoning | বেশি memory-র GPU node |
| T3 সাধারণ ও ভিশন | Qwen3.5 4B, quantized | 32K | পরিসরে সাধারণ কাজ ও image বোঝা | প্রতিটি compatible GPU |
| T3 বিকল্প পর্যালোচনা | Gemma 4 E4B, quantized | 8K | ভিন্নধর্মী review path | প্রতিটি compatible GPU |
| T4 কোড | Granite 4.2 3B, quantized | 16K | ছোট edit, tool call, structured output | প্রতিটি compatible GPU |
| T4 শ্রেণিবিন্যাস | Qwen3.5 2B, quantized | 16K | Classification, extraction ও rewriting | প্রতিটি compatible GPU |
| T4 রাউটার | Qwen3.5 0.8B, high precision quantization | 16K | Intent, label, title ও ছোট transformation | প্রতিটি compatible GPU |
| T4 এমবেডিং | Qwen3 Embedding 0.6B, quantized | 32K | Agent memory, RAG, code retrieval ও clustering | প্রতিটি compatible GPU |
এই context value deployment setting, model-এর advertised limit নয়। বড় advertised window-ও KV cache এবং runtime memory নেয়। এক কার্ডে স্থিতিশীল service-এর জন্য আমরা কম value বেছে নিয়েছি।
Qwen Qwen3.5-কে multimodal family হিসেবে বর্ণনা করে এবং Qwen3.5 সংগ্রহ -এ ছোট থেকে বড় dense variant প্রকাশ করে। IBM Granite 4.2 8B -এর agentic coding ও long-context result প্রকাশ করে। Google জানায় Gemma 4 multimodal input, function calling এবং বড় advertised window সমর্থন করে।
Embedding route chat model-কে vector বানাতে না বলে আলাদা model ব্যবহার করে। Qwen3 Embedding 0.6B মডেল কার্ড -এ 32K sequence length, multilingual retrieval, code retrieval এবং সর্বোচ্চ 1,024 output dimension উল্লেখ আছে।
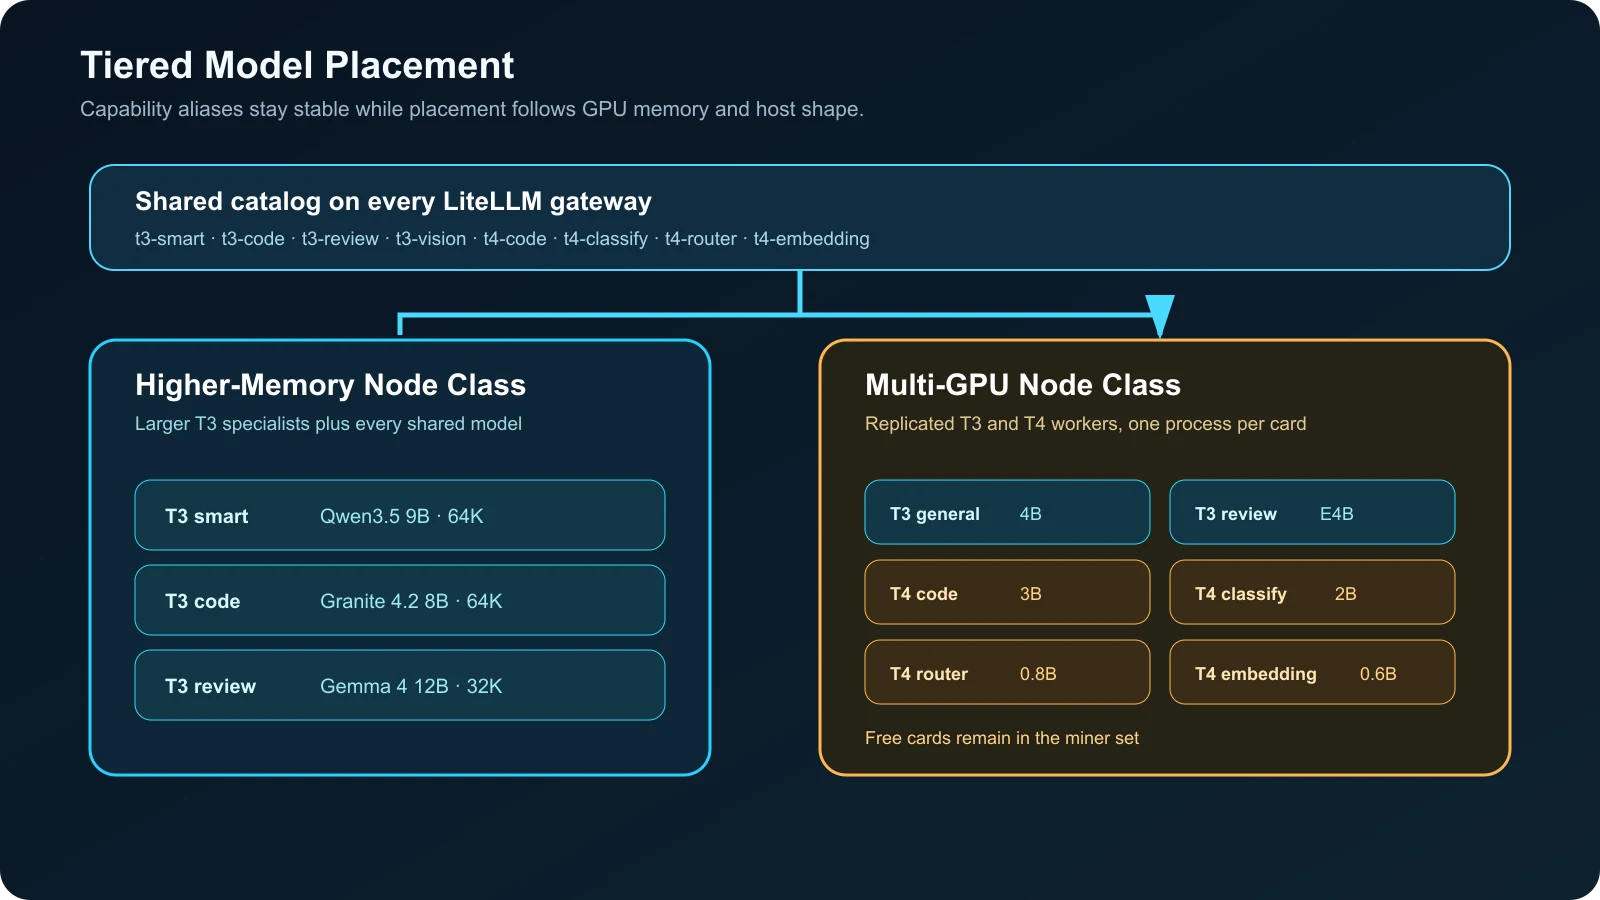
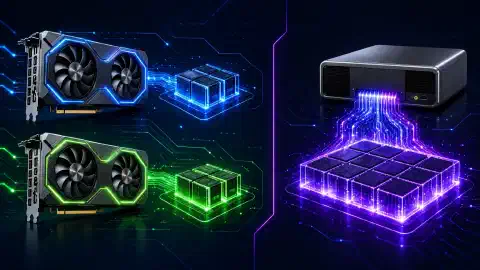
বড় specialist বেশি memory-র কার্ডে থাকে, ছোট specialist-রা পুরো fleet-এ replica হিসেবে চলে
কেন llama.cpp উৎপাদন পরিবেশে চলে
llama.cpp এই resource model-এর সঙ্গে মানানসই। একটি static worker একটি GPU, একটি model file, একটি configured context এবং একটি lease-এর সঙ্গে যুক্ত। Process boundary startup, teardown, GPU visibility এবং log audit সহজ করে।
এর server OpenAI-compatible chat, responses ও embeddings প্রকাশ করে। এটি parallel decoding এবং continuous batching-ও সমর্থন করে। বর্তমান server documentation multimodal support-কে experimental বলে। এই feature-গুলো llama.cpp server-এর নথি -এ আছে।
বড় node-এ compatibility path হিসেবে Ollama চালু থাকে। Memory যথেষ্ট হলে Ollama একাধিক model একসঙ্গে load করতে এবং
Ollama-র সাধারণ প্রশ্নোত্তর
-এ নথিভুক্ত keep_alive: 0 দিয়ে তাৎক্ষণিক unload করতে পারে। Per-card production path-এর জন্য Ollama নিইনি, কারণ static llama.cpp worker placement ও teardown আরও নিখুঁতভাবে নিয়ন্ত্রণ করেছে।
আমরা Strata-ও পর্যালোচনা করেছি। Strata এমন একটি বড় Qwen mixture-of-experts model লক্ষ্য করে, যা GPU memory, system RAM ও storage জুড়ে চলে। প্রকাশিত preset-গুলো 32 GB combined memory থেকে শুরু হয়, আর low-RAM mode কম capacity-এর বিনিময়ে গতি কমায়। দেখুন Strata কোড সংগ্রহশালা । Strata অন্য লক্ষ্য পূরণ করে: এক বা একাধিক কার্ডে একটি বড় hybrid model। আমাদের fleet অনেকগুলো স্বাধীন 12B-এর নিচের worker-কে অগ্রাধিকার দেয়।
প্রতি GPU-তে চাহিদা অনুযায়ী লোডিং
প্রতিটি model worker-এ চাহিদা অনুযায়ী লোডিং প্রযোজ্য। Request-এর মধ্যবর্তী সময়ে system শুধু gateway, pool proxy, watchdog এবং miner চালু রাখে।
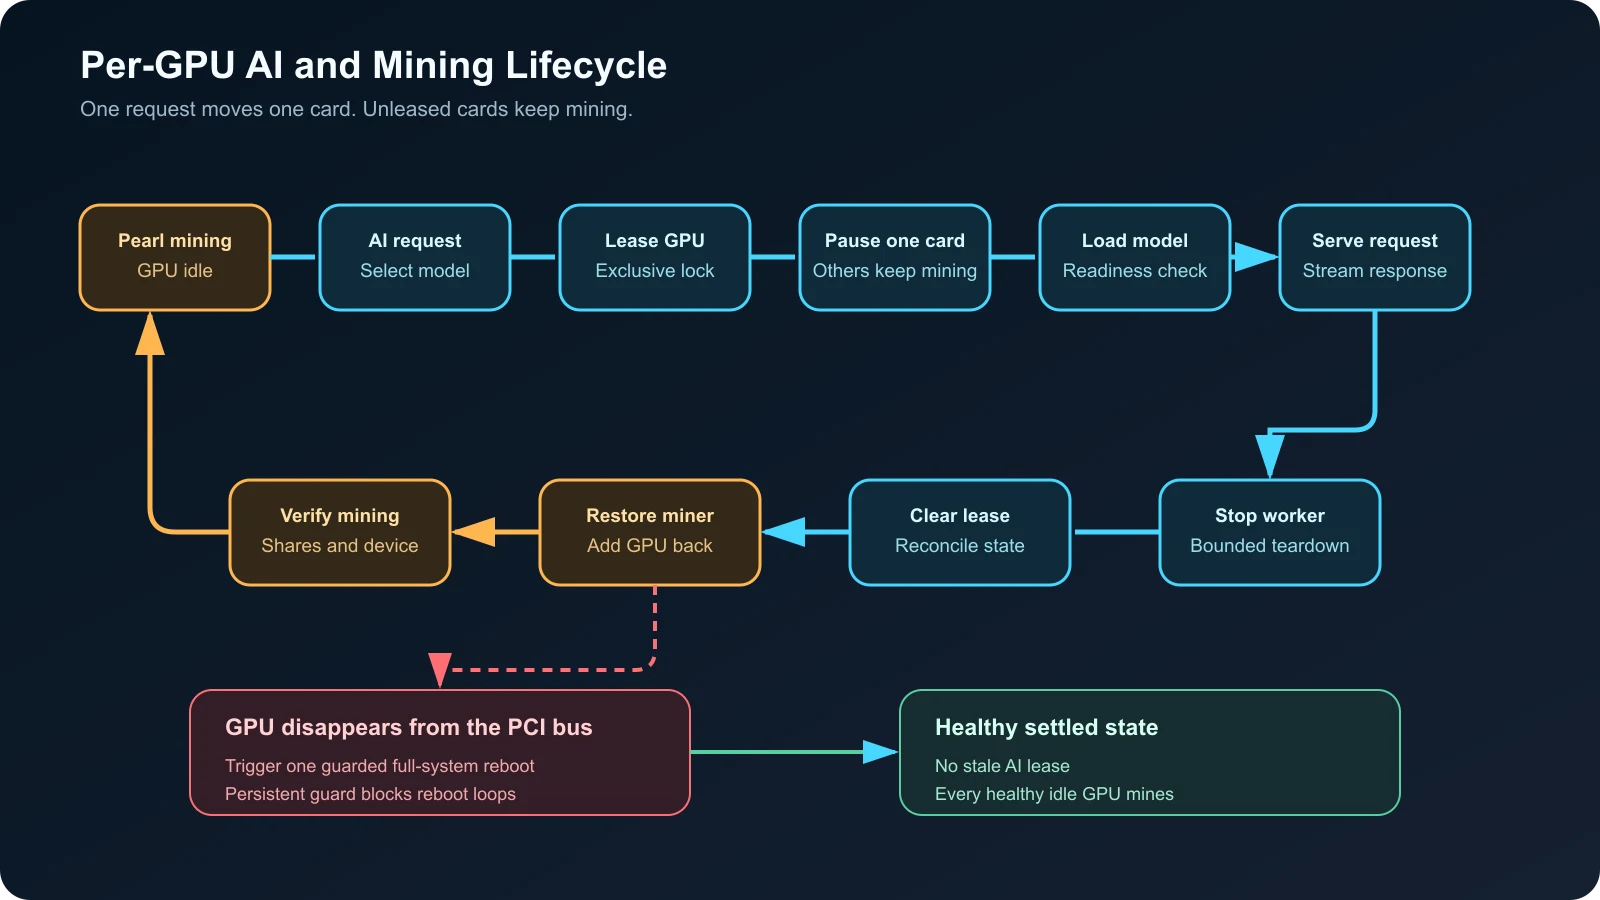
শুধু lease নেওয়া কার্ড miner থেকে সরে যায়, model process শেষ হলে ফিরে আসে
Request lifecycle-এর ধাপগুলো:
- LiteLLM deployment বেছে নেয়। Request নির্বাচিত model class-এর pool proxy-তে যায়।
- Pool lease নেয়। Lock দুইটি exclusive worker-কে একই কার্ড নিতে বাধা দেয়।
- একটি GPU বাদ দিয়ে miner restart হয়। Lease না নেওয়া প্রতিটি কার্ড Pearl command-এ থাকে।
- Lease নেওয়া device-এ llama.cpp শুরু হয়। Proxy request পাঠানোর আগে readiness check শেষ হয়।
- Worker response দেয়। একসঙ্গে আসা request অন্য ফাঁকা কার্ডে worker চালায়।
- Worker বন্ধ হয়। Process teardown-এর পর pool lease সরায়।
- মুক্ত GPU-সহ miner restart হয়। Health check নিশ্চিত করে কার্ড mining-এ ফিরেছে।
এটি host পুরোটা একবারে বদলে দেওয়ার পদ্ধতি নয়। একাধিক কার্ডের chassis কয়েকটি model সেবা দেয়, অন্য কার্ডগুলো mining চালায়। Fleet idle হলে সব সুস্থ GPU Pearl-এ ফেরে।
Pearl শ্বেতপত্র -এ matrix-computation proof system বর্ণিত হয়েছে। আমাদের architecture profitability forecast বা অর্থনৈতিক return-এর দাবির উপর নির্ভর করে না। Mining হলো idle সময়ের জন্য configured workload।
শুরু করার চেয়ে ব্যর্থতা সামলানো বেশি জরুরি
Model startup lifecycle-এর অর্ধেক। Force stop, GPU উধাও হওয়া, মাঝপথে থেমে যাওয়া request, stale lease এবং miner restart-এর জন্য স্পষ্ট ব্যবস্থা দরকার।
Watchdog configured GPU set-এর সঙ্গে live NVIDIA device list তুলনা করে। GPU নিখোঁজ নিশ্চিত হলে একবার guard-সহ পুরো system reboot করে। নিরাপদ production trigger-এ repeated failed check, cooldown, active job drain, persistent reboot counter এবং remote alert থাকা উচিত। একবার recovery ব্যর্থ হলে automation বন্ধ হয়ে manual intervention চাইবে।
একই watchdog stale lease-ও মিলিয়ে দেখে। কোনো worker lease না রাখলে reconciliation পুরোনো record মুছে GPU-কে miner-এ ফিরিয়ে দেয়। Broker canary-র সময় এই recovery path কাজে লেগেছিল।
| ব্যর্থতা | প্রতিক্রিয়া |
|---|---|
| Model readiness ব্যর্থ হয় | Worker বন্ধ করুন, lease ছাড়ুন, mining ফেরান, error দিন |
| Request অপ্রত্যাশিতভাবে শেষ হয় | Cleanup-এর সময়সীমা বাঁধুন, worker process tree শেষ করুন, lease reconcile করুন |
| GPU উধাও হয় | বারবার অনুপস্থিতি নিশ্চিত করুন, active কাজ drain করুন, একবার guarded reboot দিন, alert পাঠান, তারপর পুরো configured GPU set যাচাই করুন |
| Miner idle card বাদ দেয় | Active lease থেকে device list নতুন করে বানিয়ে miner restart করুন |
| LiteLLM deployment ব্যর্থ হয় | একই model group-এর অন্য replica-তে retry করে fallback policy অনুসরণ করুন |
| Aperture grant route আটকায় | Identity বা model grant ঠিক করুন, gateway policy এড়িয়ে যাবেন না |
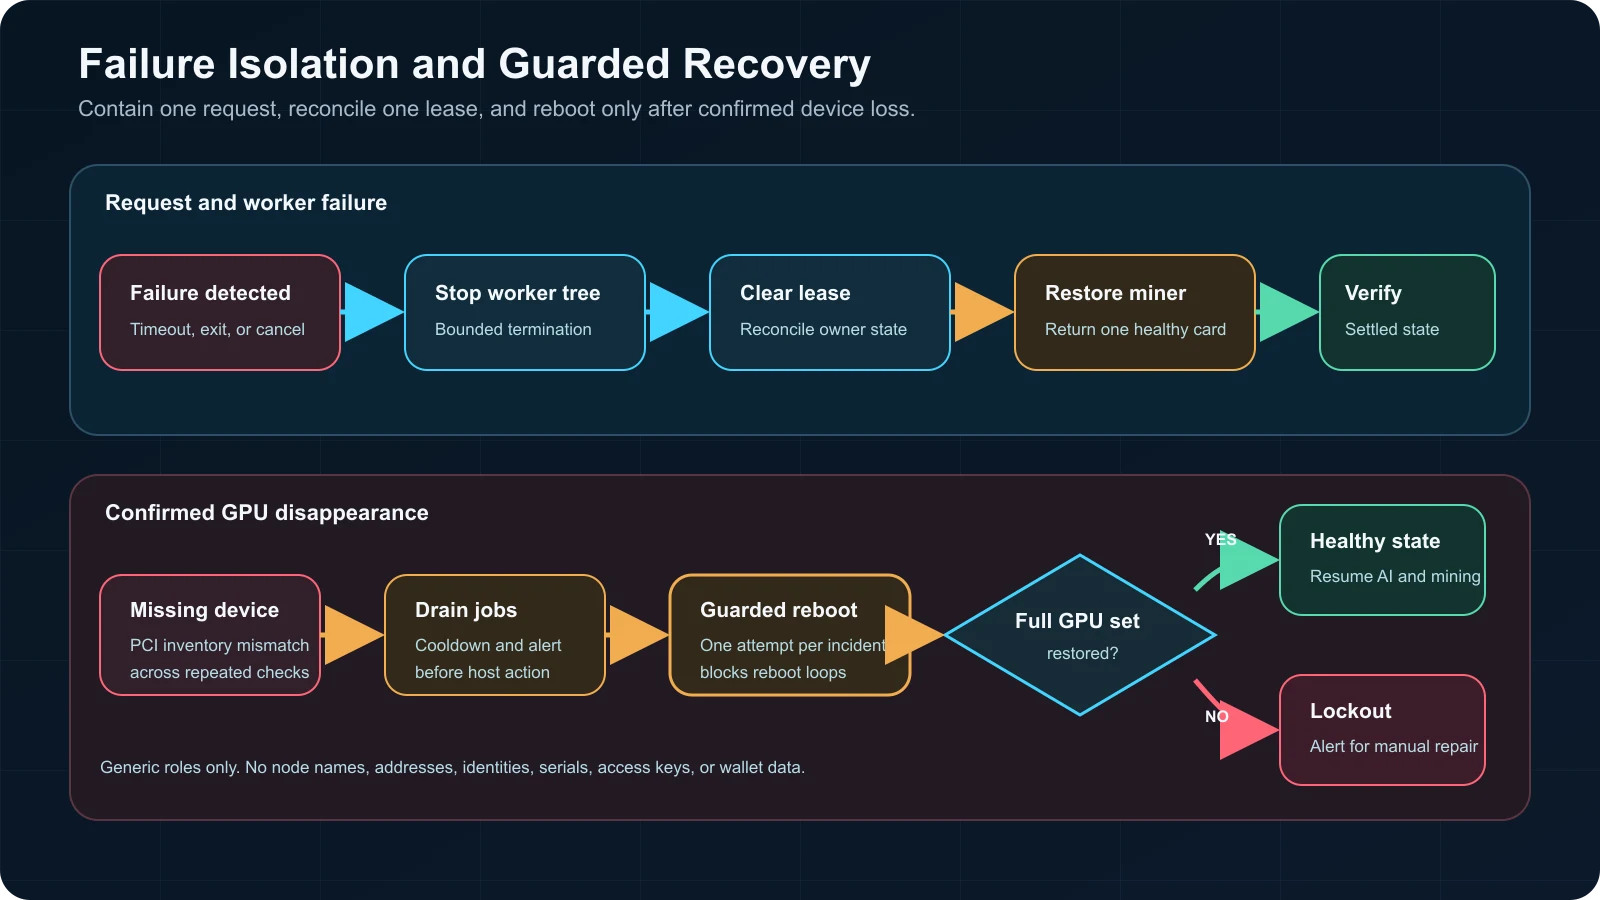
সাধারণ failure একটি lease ছাড়ে, নিশ্চিত device loss guarded host-recovery path চালু করে
পরীক্ষামূলক মধ্যস্থতাকারীর সঙ্গে কী ঘটেছিল
ব্যাকএন্ড-নিরপেক্ষ মধ্যস্থতাকারী Ollama, vLLM, llama.cpp ও Strata জুড়ে একটি OpenAI-compatible surface দিতে চায়। এতে প্রতি-model lifecycle management, idle unload এবং GPU placement আছে।
আমরা ২১ অক্টোবর ২০২৬-এ commit c12b65-এ broker version 0.6.0 পরীক্ষা করেছি। এর local suite-এ 1,101টি test pass এবং 2টি skip হয়, Ruff-এ ত্রুটি ছিল না। Canary পরে চাহিদামতো model load করে সফল chat request সেবা দেয়। Request চলার সময় অন্য GPU-গুলো mining চালায়।
Shutdown-এ lifecycle-এর গুরুতর সমস্যা দেখা দেয়। Model load হওয়ার পর systemd process tree মেরে না ফেলা পর্যন্ত broker stop path-এ আটকে থাকে। জোর করে stop করায় stale GPU lease পড়ে থাকে, reconciliation miner ফিরিয়ে আনার আগ পর্যন্ত। Documented required-GPU setting এবং production adapter-এর enforcement-এর মধ্যেও ফাঁক ছিল।
Production path-এ broker বন্ধ করেছি। LiteLLM এখন request-scoped pool proxy দিয়ে routing করে। Child process-এর bounded shutdown, process-group termination, required-GPU admission check এবং stale-lease cleanup integration test পাস না করা পর্যন্ত broker পরীক্ষামূলক থাকবে।
এটি একটি কার্যকর engineering শিক্ষা। একবার model চালু করলেই broker সম্পর্কে বেশি কিছু প্রমাণ হয় না। Production readiness-এর জন্য পরিষ্কার teardown, bounded recovery, exclusive device admission এবং পুনরাবৃত্তিযোগ্য failure drill দরকার।
যে যাচাইকরণ করেছি
Deployment test শুধু model response দেখেনি:
- প্রতিটি shared chat model অন্তত একটি যোগ্য host-এ load, answer, exit এবং Pearl recovery cycle শেষ করেছে।
- Chat route-এ vision image input গ্রহণ করেছে।
- Private LiteLLM path দিয়ে embedding configured vector size ফিরিয়েছে।
- পৃথক কার্ডে একাধিক model একই সময়ে চলেছে।
- একসঙ্গে AI request চললেও lease না-নেওয়া কার্ড miner-এ থেকেছে।
- Shared alias যোগ্য node জুড়ে routing করেছে।
- Node-prefixed alias নির্ধারিত placement বজায় রেখেছে।
- প্রতিটি LiteLLM gateway একই logical catalog দেখিয়েছে।
- পুরো host একবার reboot করার পর নিখোঁজ GPU ফিরে এসেছে। Watchdog-এ এখন persistent loop guard আছে।
- Lease reconciliation-এর মাধ্যমে broker shutdown failure সামলানো হয়েছে।
- স্থিতিশীল চূড়ান্ত অবস্থায় AI lease ছিল না, এবং প্রতিটি সুস্থ GPU আবার miner set-এ ছিল।
Health check ও model list-কে model-load test ধরা হয়নি। কার্যকর acceptance test বাস্তব request পাঠায়, response পরীক্ষা করে, নির্বাচিত GPU নিশ্চিত করে, teardown দেখে এবং mining recovery যাচাই করে।
ফ্লিটের সমস্যা সমাধান
| লক্ষণ | প্রথমে যা দেখবেন |
|---|---|
| Model দেখা যায়, কিন্তু request ব্যর্থ হয় | Upstream model ID, API format, auth header এবং provider base URL |
| Aperture 405 ফেরায় | Provider root-এ duplicate /v1 suffix নেই কি না |
| ভুল node request সেবা দেয় | Shared alias নাকি node-prefixed alias |
| দুই worker একই কার্ড চায় | Lease lock, stale lease state এবং GPU admission logic |
| সব কার্ডে mining বন্ধ হয় | Miner restart code active lease থেকে device list বানায় কি না |
| GPU mining-এর বাইরে থাকে | Worker process tree, lease reconciliation এবং miner device list |
| Cold load ধীর | Model size, storage speed, PCIe link width এবং host CPU pressure |
| লম্বা prompt ব্যর্থ হয় | Configured context, KV cache headroom এবং output reservation |
| Aperture-এ embedding route নেই | Tailscale identity ও host firewall policy দিয়ে সীমিত authenticated LiteLLM route ব্যবহার করুন |
| Broker stop আটকে যায় | Broker route বন্ধ করে যাচাইকৃত pool proxy-তে traffic ফেরান |
যে নকশার নিয়মগুলো রাখব
- কাজের উদ্দেশ্য দেখে route করুন। Model size একা tier নির্ধারণ করে না।
- Placement-এর উপরে policy রাখুন। Hermes capability alias বেছে নেয়। LiteLLM deployment বেছে নেয়। Pool GPU বেছে নেয়।
- প্রতিটি GPU-কে পৃথক lease হিসেবে ধরুন। পুরো host বদলালে উপলভ্য কার্ড নষ্ট হয়।
- নিষ্ক্রিয় model unload করুন। চালু gateway-এর জন্য চালু GPU worker দরকার হয় না।
- সীমিত exact-placement path রাখুন। Operator-only node alias diagnostic পুনরুৎপাদনযোগ্য করে।
- আগে teardown পরীক্ষা করুন। Miner recovery ও lease cleanup acceptance test-এর অংশ।
- Chat, vision ও embedding আলাদা রাখুন। একটি gateway মানেই একটি protocol path নয়।
- Diagram-এ private detail দেবেন না। Address, key, identity বা wallet data নয়, role ও flow প্রকাশ করুন।
- Reboot logic-এ guard দিন। বারবার অনুপস্থিতি, cooldown, persistent counter, alert এবং একটি recovery ব্যর্থ হলে manual intervention চাই।
- Experimental bypass রাখুন। Broker ব্যর্থ হলে যাচাইকৃত route-ও যেন সঙ্গে ব্যর্থ না হয়।
পরবর্তী ধাপ
পরবর্তী পর্যায়ে workload evaluation হবে। প্রতিটি tier-এ নির্দিষ্ট task set, acceptance criteria, latency record, GPU occupancy, mining interruption time এবং escalation rate দরকার। পরিমাপগুলো দেখাবে কোন T2 কাজ T3-তে এবং কোন T3 কাজ T4-তে মানায়।
আমরা Hermes থেকে Aperture হয়ে LiteLLM-এ প্রথম acceptance test চালাতে চাই। এরপর broker-এর shutdown ও GPU admission path ঠিক করে আবার পরীক্ষা করব। একই routing catalog-এ যোগ করার আগে image generation-এর জন্য নিজস্ব lazy OpenAI-compatible adapter দরকার।
Model size বাছাইয়ে স্থানীয় AI মডেল ও GPU context guide পড়ুন। Privacy boundary-এর জন্য পড়ুন স্থানীয় AI privacy ও security . Miner setup ও ঝুঁকি জানতে Pearl মাইনিং নির্দেশিকা দেখুন, নিষ্ক্রিয় সময়ের mining-কে নিশ্চিত লাভ মনে না করে।
Related Posts