AI সাইবার নিরাপত্তা সার্টিফিকেশন: বাস্তব চর্চার সঙ্গে তাল মেলাতে পারছে না

Table of Contents
আমরা পরীক্ষা দিয়েছি। পাস করেছি। সার্টিফিকেট পেয়েছি, কিন্তু এমন এক ধরনের হতাশাও ছিল, যেটা আমি নির্দিষ্ট করে ব্যাখ্যা করতে চাই।
এই কর্মসূচিগুলো তৈরি করা মানুষদের বিরুদ্ধে অভিযোগ নয়। তারা অসম্পূর্ণ উপকরণ নিয়ে কাজ করছেন। AI security একটি নতুন ক্ষেত্র। আক্রমণ নিয়ে গবেষণা প্রতিরক্ষামূলক সরঞ্জামের চেয়ে দ্রুত এগোচ্ছে। engineering নির্দেশনার আগে governance framework এসেছে।
সমস্যা হলো সার্টিফিকেশনে যা শেখানো হয় এবং উৎপাদনে AI system সুরক্ষিত করতে যা জানা দরকার, এই দুয়ের ব্যবধান।
যে তিনটি স্তর প্রায়ই গুলিয়ে যায়
কী অনুপস্থিত তা বলার আগে বর্তমানে যা আছে, সেগুলো আলাদা করে দেখা দরকার।
প্রথম স্তর হলো governance। NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 এবং EU AI Act-এর মতো নথি প্রতিষ্ঠান ও প্রক্রিয়ার পর্যায়ে কাজ করে। এগুলো AI ঝুঁকি পরিচালনা, তদারকি কাঠামো তৈরি এবং জবাবদিহি নথিভুক্ত করার পদ্ধতি বর্ণনা করে। এগুলো ইচ্ছাকৃতভাবে নির্দিষ্ট control দেওয়ার বদলে governance-কেন্দ্রিক। নকশাটিই এমন।
দ্বিতীয় স্তর হলো threat taxonomy। MITRE ATLAS, ATT&CK-এর একই বিন্যাসে AI system-এর বিরুদ্ধে প্রতিপক্ষের কৌশল নথিভুক্ত করে। OWASP Top 10 for Large Language Model Applications চালু LLM-এর জন্য প্রাসঙ্গিক আক্রমণের ধরন তালিকাভুক্ত করে। এই নথিগুলো আক্রমণের নাম এবং কাজের পদ্ধতি জানায়। প্রতিরক্ষার নির্দেশ দেয় না।
তৃতীয় স্তর হলো প্রযুক্তিগত নির্দেশনা। এর মধ্যে রয়েছে Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile), এবং Anthropic, OpenAI ও Meta-র মতো vendor-এর নিরাপত্তা নথি। এগুলো নিরাপদ deployment, evaluation practice এবং runtime control নিয়ে engineering-পর্যায়ের নির্দেশনা দেয়।
বেশিরভাগ AI governance সার্টিফিকেশন প্রথম স্তর বিস্তারিতভাবে শেখায়। দ্বিতীয় স্তরের সারসংক্ষেপ দেয়। তৃতীয় স্তর খুব কমই আলোচনা করে।
সার্টিফিকেশনগুলো কী শেখায়
বর্তমানে পাওয়া AI governance ও security সার্টিফিকেশন, যেমন IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, ISO 42001 সার্টিফিকেশন এবং CompTIA AI+, প্রায় একই ধরনের বিষয় শেখায়।
তুমি NIST AI RMF এবং এর চারটি কাজ, Govern, Map, Measure ও Manage, প্রতিষ্ঠানের AI deployment-এর সঙ্গে কীভাবে মেলাতে হয় তা শেখো। EU AI Act-এর ঝুঁকির স্তর এবং উচ্চ-ঝুঁকির system-এর conformity assessment পদ্ধতি শেখো। governance নীতি হিসেবে পক্ষপাত, ন্যায্যতা, স্বচ্ছতা এবং জবাবদিহি শেখো। AI governance policy লেখা ও impact assessment করার পদ্ধতিও শেখো।
এগুলো বাস্তব দক্ষতা। প্রতিষ্ঠানের এমন মানুষ দরকার, যারা governance framework বোঝে, NIST AI RMF পড়ে এবং এতে কী তৈরি করতে বলা হয়েছে তা জানে।
সার্টিফিকেশনগুলো একই গভীরতায় শেখায় না:
- আক্রমণকারীরা বর্তমানে production AI system কীভাবে compromise করে
- prompt injection-এর defense-in-depth বাস্তবে কেমন এবং একক control কেন এটি দূর করতে পারে না
- deployment-এর আগে model integrity কীভাবে যাচাই করতে হয়
- AI-নির্দিষ্ট red teaming-এ কী থাকে এবং এর scope কীভাবে ঠিক করতে হয়
- launch-এর আগে adversarial input-এর বিরুদ্ধে model behavior কীভাবে মূল্যায়ন করতে হয়
- inference-এর সময় AI observability কেমন
- AI incident response, প্রচলিত IR playbook থেকে কীভাবে আলাদা
- tool access ও external integration থাকা AI agent সুরক্ষিত করতে কী দরকার
NIST AI RMF governance-এর জন্য, engineering-এর জন্য নয়
NIST AI RMF একটি ভালোভাবে তৈরি নথি। NIST এটিকে প্রযুক্তি-নিরপেক্ষ, খাত-নিরপেক্ষ এবং বিভিন্ন AI development পদ্ধতিতে প্রযোজ্য হিসেবে নকশা করেছে। ফলে framework-টি বিস্তৃতভাবে প্রযোজ্য।
এর মানে এইও যে নির্দিষ্ট আক্রমণের ধরনের জন্য এটি প্রযুক্তিগত control নির্ধারণ করে না। প্রতিষ্ঠানটি পুরো AI RMF গ্রহণ করে এর সব কাজ AI deployment-এর সঙ্গে মিলিয়ে নিলে নথিভুক্ত risk process পাবে। কিন্তু deployed language model-এ prompt injection ঠেকানোর ব্যবস্থা নিশ্চিতভাবে পাবে না।
NIST এটি স্বীকার করে। 2024 সালে প্রকাশিত NIST AI 600-1, Generative AI Profile, generative AI ও large language model-এর জন্য AI RMF-কে সম্প্রসারিত করে। এতে prompt injection, data poisoning এবং information hazard-এর মতো ঝুঁকি মূল AI RMF-এর চেয়ে বেশি নির্দিষ্টভাবে রয়েছে। তোমার সার্টিফিকেশনে AI 600-1 ছাড়া শুধু মূল AI RMF থাকলে, বর্তমানে চালু system-এর জন্য সবচেয়ে প্রাসঙ্গিক নথিটি বাদ পড়েছে।
ISO 42001 এবং management system-এর তুলনা
ISO 42001:2023 হলো AI management system standard। প্রতিষ্ঠান পর্যায়ে AI development ও deployment পরিচালনার কাঠামো দেয়। security পেশাজীবীরা এতে information security-র ISO 27001-এর সঙ্গে মিল দেখতে পাবেন।
ISO 27001 ব্যাপকভাবে ব্যবহৃত হয়। সার্টিফাইড প্রতিষ্ঠানও breach-এর শিকার হয়। সার্টিফিকেশন নথিভুক্ত করে যে management system আছে, নির্দিষ্ট প্রক্রিয়া অনুসরণ করে এবং review হয়। এই প্রক্রিয়ার অধীনে থাকা system আক্রমণ প্রতিরোধ করবে, তা প্রমাণ করে না।
ISO 42001 প্রতিষ্ঠানকে নিয়মানুবর্তিতা দেয়। সার্টিফিকেশন জানায় যে AI process নথিভুক্ত, review করা এবং governance-এর অধীন। এটি প্রমাণ করে না যে deployed model adversarial অবস্থায় ধারাবাহিক ফল দেয়, agent নির্ধারিত trust boundary মানে, বা fine-tuned model যাচাইকৃত training data থেকে তৈরি।
ISO 27001-এর ক্ষেত্রেও একই ব্যবধান আছে। প্রচলিত cybersecurity-তে আমরা এই সীমাবদ্ধতা নিয়ে চলতে শিখেছি। একই কাঠামোগত সীমা থাকা AI governance সার্টিফিকেশন সেই ব্যবধান পূরণ করে, এমন ভান করা উচিত নয়।
EU AI Act ফলাফল চায়, engineering specification নয়
EU AI Act ঝুঁকির স্তর অনুযায়ী AI system ভাগ করে: অগ্রহণযোগ্য (নিষিদ্ধ), উচ্চ (conformity assessment দরকার), সীমিত (স্বচ্ছতার বাধ্যবাধকতা) এবং ন্যূনতম (নির্দিষ্ট শর্ত নেই)।
গুরুত্বপূর্ণ অবকাঠামো, biometric identification, চাকরির বাছাই, শিক্ষা এবং আইন প্রয়োগে ব্যবহৃত উচ্চ-ঝুঁকির system-এ technical documentation, মানব তদারকি এবং robustness-এর শর্ত থাকে। আইন স্পষ্টভাবে চায়, adversarial manipulation দিয়ে আচরণ বদলানোর প্রচেষ্টার বিরুদ্ধে উচ্চ-ঝুঁকির AI system দৃঢ় হোক।
শর্তটি আইনের পাঠে আছে। আইনটি ইচ্ছাকৃতভাবে technical control নয়, ফলাফল নির্ধারণ করে। সব deployment context, system type ও use case-এ adversarial robustness দেখানোর প্রযুক্তিগত পদ্ধতি নিয়ে এখনও সর্বসম্মত উত্তর নেই।
EU AI Act-ভিত্তিক সার্টিফিকেশন AI system শ্রেণিবদ্ধ করা, technical documentation লেখা এবং oversight protocol গঠনের প্রস্তুতি দেয়। এগুলো audit-এর জন্য প্রস্তুত করে। আইনের robustness শর্ত পূরণ করে এমন system তৈরির engineering কাজ বর্তমান সার্টিফিকেশনের আওতার বাইরে অন্য ক্ষেত্র।
AI system-কে আসলে কী আক্রমণ করে
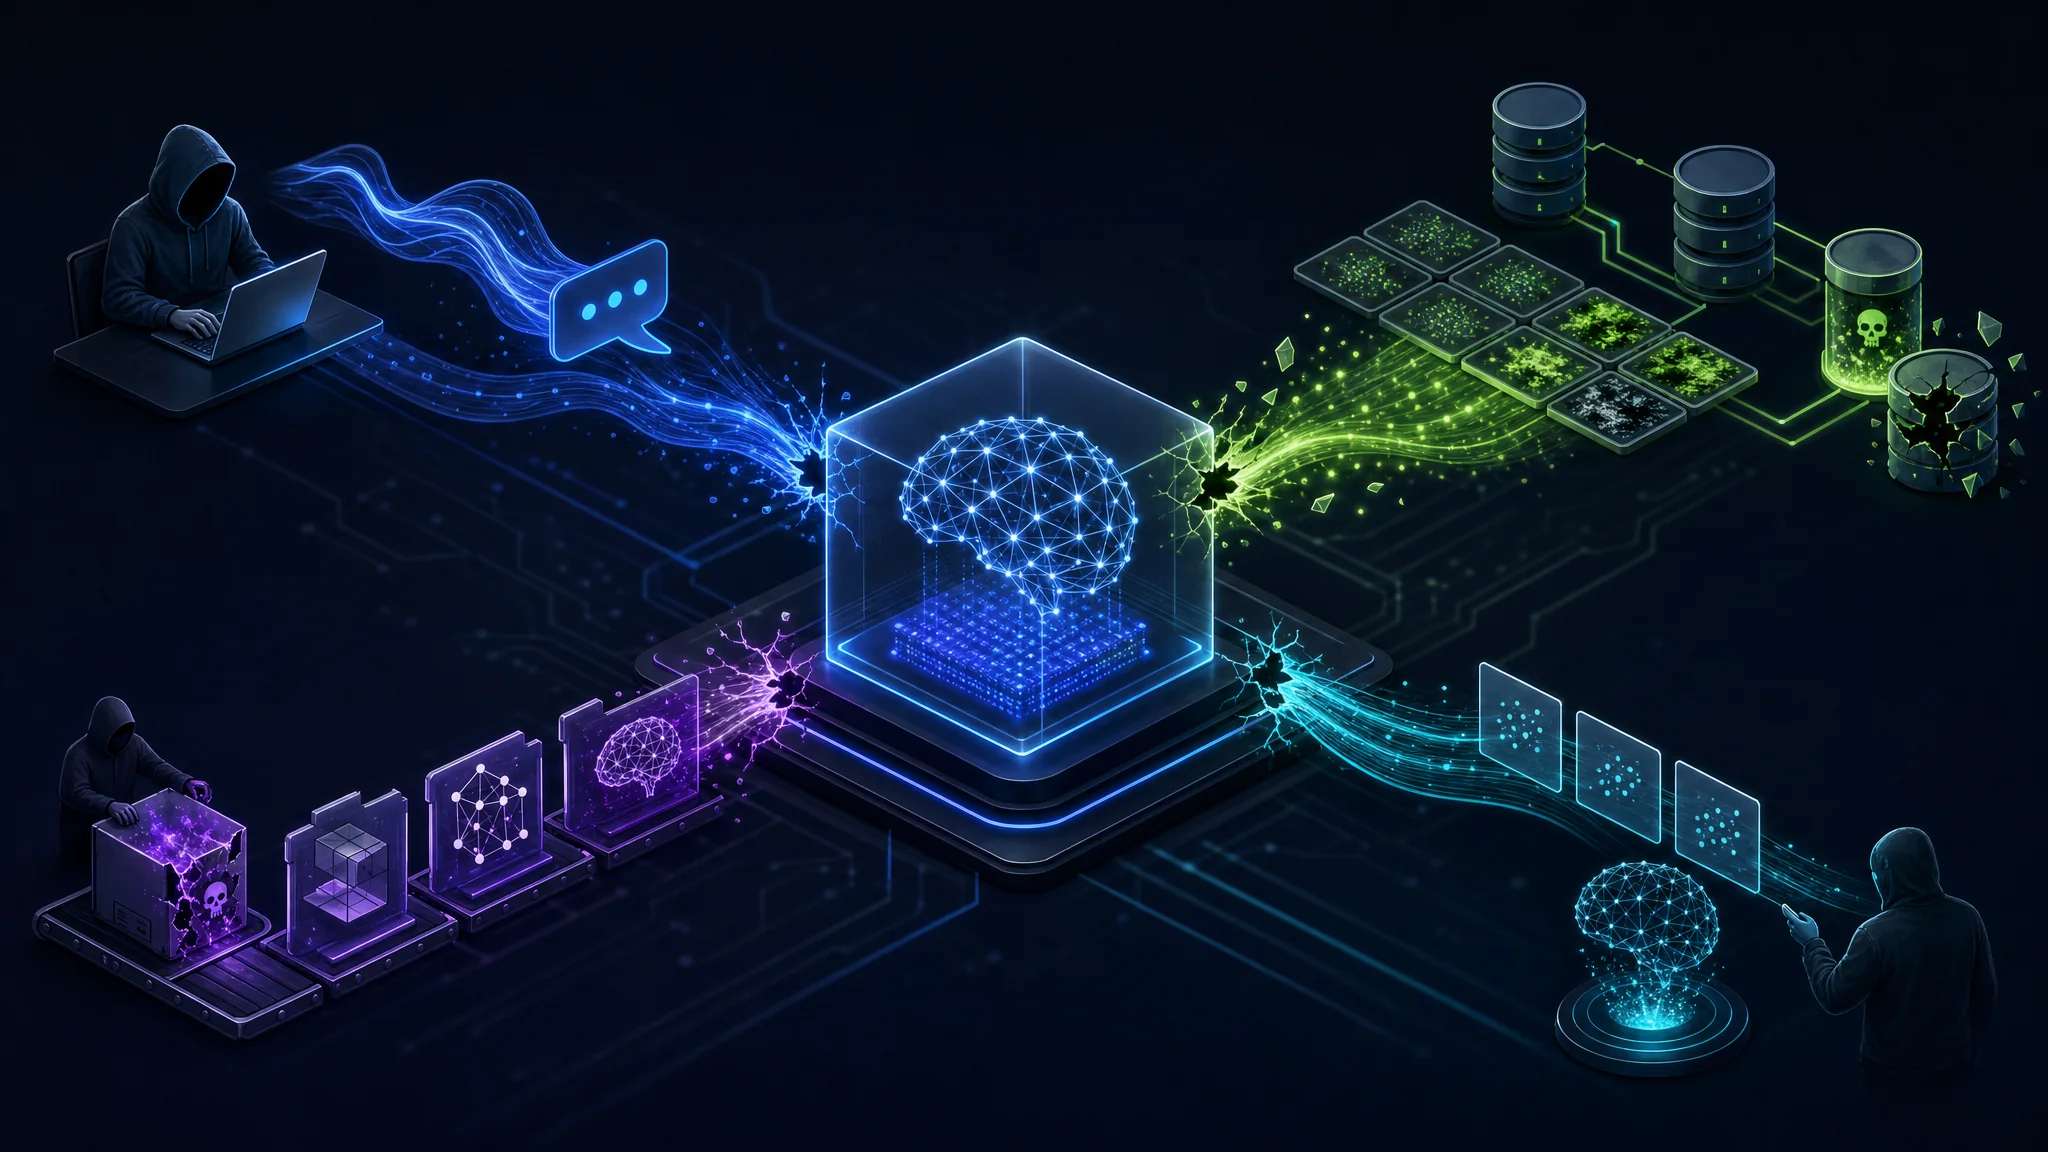
MITRE ATLAS এবং OWASP LLM Top 10 বাস্তব threat landscape নথিভুক্ত করে। এগুলো ব্যবহারযোগ্য বিস্তারিতভাবে আক্রমণের ধরন তালিকাভুক্ত করে। Governance framework-এ হুমকির বর্ণনা আরও বিমূর্ত। পরের তথ্যগুলো নির্দিষ্ট security source থেকে এসেছে।
Prompt injection-এ language model-কে এমন input দেওয়া হয় যা system instruction অতিক্রম বা প্রভাবিত করে। Direct injection সরাসরি model input-কে লক্ষ্য করে। Indirect injection-এ model যে content সংগ্রহ, প্রক্রিয়া বা সংক্ষেপ করে তার মধ্যে ক্ষতিকর instruction লুকানো হয়। তোমার RAG pipeline আক্রমণকারীর নিয়ন্ত্রণাধীন document পড়ে এবং তার মধ্যে লুকানো instruction কার্যকর করে। তোমার browsing agent আক্রমণকারীর নিয়ন্ত্রণাধীন page-এ গিয়ে embedded নির্দেশ অনুসরণ করে। তোমার customer support bot এমন support article সংক্ষেপ করে যাতে safety guideline উপেক্ষা করতে বলা হয়েছে।
2026 সালেও prompt injection-এর জন্য সর্বত্র কার্যকর mitigation নেই। Defense-in-depth ঝুঁকি কমায়: input filtering, output validation, সীমিত privilege-এর tool scope, sandbox করা execution environment এবং গুরুত্বপূর্ণ কাজের আগে মানব অনুমোদন। কোনোটিই আক্রমণের ধরনটি পুরোপুরি দূর করে না। NIST, OWASP, Anthropic, OpenAI, Google এবং Microsoft একক সমাধানের বদলে স্তরভিত্তিক control-এর সুপারিশ করে।
Training data poisoning-এ model-এর আচরণ খারাপ করা, backdoor যোগ করা বা trigger-নির্ভর আচরণ বসানোর জন্য training data-তে ক্ষতিকর উদাহরণ ঢোকানো হয়। model নির্দিষ্ট trigger input না পাওয়া পর্যন্ত সফল poisoning-এর ইঙ্গিত অনেক সময় থাকে না। তোমার প্রতিষ্ঠান user-generated content, সংগৃহীত document বা তৃতীয় পক্ষের dataset থেকে model fine-tune করে এবং উৎস যাচাই না করলে এই ঝুঁকি থাকে।
Model supply chain compromise এমন হুমকি, যেটিকে অধিকাংশ প্রতিষ্ঠান পরে ভাবার বিষয় মনে করে। Model repository প্রায়ই model weight-এর সঙ্গে executable code বিতরণ করে। pickle-এর মতো অনিরাপদ serialization format বারবার supply chain ঝুঁকি তৈরি করেছে। model download-এর সঙ্গে আসা package নিজের দুর্বলতাসহ dependency ইনস্টল করতে পারে। অনেক প্রতিষ্ঠান public repository থেকে নেওয়া model-এ software dependency-র তুলনায় অনেক কম supply chain scrutiny চালায় বলে মনে হয়। attack surface npm-এর সঙ্গে তুলনীয়, কিন্তু এখানে security culture এখনও অনেক নতুন।
Model extraction-এ আক্রমণকারীরা তোমার API-তে বারবার inference query পাঠিয়ে কার্যগতভাবে কাছাকাছি model পুনর্গঠন করে। এতে intellectual property হারায় এবং model offline-এ বিশ্লেষণ করে আরও লক্ষ্যভিত্তিক আক্রমণ তৈরির সুযোগ হয়।
Membership inference-এ আক্রমণকারীরা বিভিন্ন মাত্রার নিশ্চয়তায় নির্ধারণ করতে পারে নির্দিষ্ট data record training set-এ ছিল কি না। এটি model architecture ও training পদ্ধতির ওপর নির্ভর করে। ব্যক্তিগত তথ্য দিয়ে model train করা প্রতিষ্ঠানের জন্য privacy ঝুঁকি তৈরি হয়।
Adversarial input পরিকল্পিত পরিবর্তনের মাধ্যমে model output-কে প্রভাবিত করে। ছবির শ্রেণিবিন্যাসে এই পদ্ধতি সবচেয়ে বেশি গবেষিত হলেও text, audio এবং multimodal system-এও প্রযোজ্য। তোমার AI যদি fraud detection, creditworthiness, medical imaging বা physical access নিয়ে সিদ্ধান্ত নেয়, adversarial robustness এমন security property যা পরীক্ষা করা দরকার, শুধু নথিভুক্ত নয়।
AI system-এর মাধ্যমে data leakage সরাসরি মনোযোগের দাবি রাখে। RAG pipeline knowledge base-এর document এমন ব্যবহারকারীকে দেখাতে পারে, যাদের access থাকা উচিত নয়। system instruction থেকে prompt leakage গোপন রাখার কথা ছিল এমন operational detail প্রকাশ করে। Multi-tenant AI deployment-এ isolation দরকার, যা প্রচলিত application security engineer কখনও কম গুরুত্ব দেন। চালু system-এ এই operational ঝুঁকি নিয়মিত দেখা যায়।
AI agent attack surface পুরোপুরি বদলে দেয়
বেশিরভাগ AI security সার্টিফিকেশন লেখা হয়েছিল যখন AI system বলতে মূলত chatbot ও classifier বোঝাত। 2026 সালে enterprise AI ক্রমেই agent-নির্ভর।
একটি operational গুরুত্বপূর্ণ দিক থেকে agent chatbot-এর চেয়ে আলাদা: এটি কাজ করে। email system, internal database, file system, browser ও code execution environment-এ tool access থাকা agent, বেশি feature-সহ chatbot নয়। এটি language model-এর output অনুযায়ী বাস্তব system-এ উল্লেখযোগ্য access-সহ কাজ করা স্বয়ংক্রিয় process।
OWASP এখন আলাদা Agentic AI Top 10 রাখে, কারণ agent-এর threat model, LLM chat application থেকে যথেষ্ট আলাদা এবং আলাদা documentation দরকার।
Agent-এর ক্ষেত্রে prompt injection অনাকাঙ্ক্ষিত text উত্তর দেয় না, অনাকাঙ্ক্ষিত কাজ ঘটায়। সংগৃহীত document-এর indirect injection agent-কে file মুছতে, data বাইরে পাঠাতে বা email পাঠাতে নির্দেশ দিতে পারে। ফল অনুপযুক্ত উত্তর নয়। ফল হলো agent-এর প্রবেশাধিকার থাকা system-এ অননুমোদিত কাজ।
Agent-এর attack surface-এ আছে:
- Tool invocation limit: প্রতিটি কাজের জন্য উপযুক্ত ন্যূনতম tool-এ agent-কে সীমাবদ্ধ রাখা হয়েছে কি না
- Credential scope: agent-এর credential প্রতিটি কাজের প্রয়োজনেই সীমাবদ্ধ কি না
- Action reversibility: গুরুত্বপূর্ণ কাজ কার্যকর করার আগে মানব অনুমোদন লাগে কি না
- Output filtering: পরবর্তী কাজ শুরু করার আগে agent-এর output যাচাই হয় কি না
- Sandboxing: execution environment সংযুক্ত system-এ অনিচ্ছাকৃত access ঠেকায় কি না
বেশিরভাগ AI governance সার্টিফিকেশন এ মাত্রার নির্দিষ্টতায় agent security design শেখায় না।
Model Context Protocol নতুন enterprise attack surface তৈরি করে
Model Context Protocol (MCP) AI agent-কে external tool, data source এবং service-এর সঙ্গে যুক্ত করার ব্যাপকভাবে গৃহীত standard হয়েছে। MCP server এমন capability প্রকাশ করে, যা agent খুঁজে ব্যবহার করে। integration দ্রুত ও নমনীয়, কিন্তু security implication-এ সবসময় সমান মনোযোগ পড়ে না।
MCP-সংক্রান্ত ঝুঁকির মধ্যে রয়েছে:
- ক্ষতিকর MCP server, যা agent-কে নিজের capability সম্পর্কে ভুল ধারণা দেয় এবং অনিচ্ছাকৃত কাজ সম্পাদন করে
- Tool poisoning, যেখানে বৈধ MCP server আক্রমণকারীর নিয়ন্ত্রণাধীন data ফেরত দিয়ে data output-এর মধ্যে instruction ঢোকায়
- অতিরিক্ত privilege-যুক্ত tool, যেখানে MCP integration কাজের প্রয়োজনের চেয়ে বেশি permission ধরে রাখে
- Trust boundary বিভ্রান্তি, যেখানে agent সংযুক্ত MCP tool-এর instruction-কে user instruction-এর সমতুল্য মনে করে
MCP integration-সহ agent চালু করা প্রতিষ্ঠানের MCP server-এর trust মূল্যায়ন, tool permission audit এবং tool response-কে instruction নয়, data হিসেবে বিবেচনার যাচাই করার framework দরকার।
Evaluation হলো সার্টিফিকেশনে বাদ পড়া operational practice
Deployment-এর আগে ও পরে AI model-এর ঝুঁকি বোঝার প্রধান উপায় হিসেবে static security assessment-এর জায়গা নিচ্ছে AI red teaming ও evaluation suite।
AI red teaming-এ রয়েছে:
- পরিচিত আক্রমণ কৌশলের বিরুদ্ধে model behavior-এর কাঠামোবদ্ধ adversarial পরীক্ষা
- প্রতিষ্ঠিত prompt attack dataset দিয়ে jailbreak benchmark
- পরিবর্তিত input-এ output drift মাপার adversarial robustness test
- model version-এর মধ্যে behavioral regression test
- প্রকাশিত evaluation suite দিয়ে safety benchmark মূল্যায়ন
NIST, Anthropic, OpenAI, Microsoft, Google এবং CISA উচ্চ-ঝুঁকির system deployment-এর আগে AI-নির্দিষ্ট red teaming-এর সুপারিশ করে। এটি ঐচ্ছিক নয়, standard expectation হয়ে উঠছে।
বর্তমান AI governance সার্টিফিকেশনগুলোর কোনোটিই deployed model বা agent system-এর বিরুদ্ধে red teaming-এর scope নির্ধারণ, পরিচালনা বা ফল ব্যাখ্যা করার যথেষ্ট প্রস্তুতি দেয় না। এগুলো red teaming কী তা বলে, কিন্তু করতে শেখায় না।
AI observability আলাদা ক্ষেত্র
প্রচলিত security logging সরাসরি AI system-এ প্রয়োগ করা যায় না। production-এ LLM বা agent monitor করতে ভিন্ন data collection ও analysis দরকার।
AI observability অবকাঠামোতে আছে:
- anomaly ও policy violation শনাক্ত করার prompt এবং output telemetry
- agent-এর tool invocation log, যেখানে কোন tool কী argument-সহ ডাকা হয়েছে তা থাকে
- RAG pipeline-এর retrieval quality monitoring
- jailbreak চেষ্টা শনাক্ত ও শ্রেণিবদ্ধ করা
- model version-এর মধ্যে drift ধরতে output consistency monitoring
- factual accuracy গুরুত্বপূর্ণ application-এ hallucination rate tracking
- context size বাড়াতে prompt injection-এর চেষ্টা বোঝাতে পারে এমন latency pattern
এটি নতুন ক্ষেত্র। 2026 সালে AI চালু করা অধিকাংশ প্রতিষ্ঠানের AI component সম্পর্কে observability প্রচলিত অবকাঠামোর তুলনায় অনেক কম। অধিকাংশ governance সার্টিফিকেশন AI system-এর যথাযথ observability কেমন তা বলে না।
AI incident response সাধারণ IR-এর মতো নয়
প্রচলিত system compromise হলে IR playbook containment, forensics এবং recovery সামলায়। AI incident এমন প্রশ্ন তোলে, যার উত্তর standard playbook-এ নেই।
প্রয়োজন হওয়ার আগেই এসব প্রশ্নের জন্য playbook তৈরি করো:
- fine-tuning-এর সময় model poison হয়েছিল কি না, কীভাবে নির্ধারণ করবে
- RAG retrieval ব্যবহার করে আক্রমণকারীর নিয়ন্ত্রণাধীন content ফেরত আনা হয়েছিল কি না, কীভাবে মূল্যায়ন করবে
- agent অননুমোদিত কাজ করেছে কি না এবং তার scope কী, কীভাবে শনাক্ত করবে
- তৃতীয় পক্ষের provider-এর model update নিরাপত্তার জন্য গুরুত্বপূর্ণভাবে আচরণ বদলেছে কি না, কীভাবে যাচাই করবে
- incident-এর আগে model-এর আচরণ কী ছিল, যাতে পরের আচরণের সঙ্গে তুলনা করা যায়, কীভাবে স্থির করবে
এর জন্য incident-এর আগেই প্রস্তুতি, আগে থেকে setup করা log ও telemetry, এবং এমন AI-নির্দিষ্ট runbook দরকার যাতে শুধু network traffic ও endpoint log নয়, model behavior-এর forensic analysis-ও থাকে।
সার্টিফিকেশন আপডেটের সমস্যা
সার্টিফিকেশন বাস্তব চর্চা থেকে পিছিয়ে থাকার একটি কাঠামোগত কারণ হলো AI security, certification update cycle-এর গতির চেয়ে দ্রুত বদলায়।
Security+, CISSP এবং ISO 27001 এমন ক্ষেত্র কভার করে, যেগুলো বছরের ব্যবধানে বদলায়। network, endpoint ও application-এর মূল attack surface তুলনামূলক স্থিতিশীল। AI attack technique কয়েক মাসে বদলে যায়। 2026 সালের prompt injection technique, adversarial attack method এবং agentic attack surface 2023 ও 2024 সালে প্রথম AI সার্টিফিকেশন চালুর সময়ের তুলনায় ভিন্ন।
সার্টিফিকেশন সংস্থা নির্দিষ্ট সময়সূচিতে উপকরণ আপডেট করে। OWASP LLM Top 10 প্রথম বছরের মধ্যেই গুরুত্বপূর্ণ revision প্রকাশ করে। বর্তমান অনেক AI সার্টিফিকেশন নকশার সময় MCP enterprise concern ছিল না। agentic AI security framework-ও অধিকাংশ বর্তমান curriculum-এর পরে এসেছে।
এটি কাঠামোগত সমস্যা, সদিচ্ছার ব্যর্থতা নয়। সার্টিফিকেশনকে স্থির জ্ঞানের ভান্ডার মনে না করে নিয়মিত primary source পড়ো।
AI security সার্টিফিকেশনের বিষয়বস্তুতে কী থাকা দরকার
সার্টিফিকেশন curriculum-এ বর্তমান AI security practice প্রতিফলিত করতে এগুলো থাকা দরকার:
- Prompt injection-এর defense-in-depth: input filtering, output validation, tool scoping, sandboxing এবং human approval gate, সঙ্গে প্রতিটির নথিভুক্ত সীমাবদ্ধতা
- Model supply chain verification: অনিরাপদ serialization-এর ঝুঁকি, SBOM requirement, provenance documentation এবং signed artifact যাচাই
- AI agent security architecture: trust boundary, ন্যূনতম privilege-এর tool access, action reversibility এবং monitoring requirement
- MCP ও external integration security: tool server trust মূল্যায়ন, tool permission audit এবং data ও instruction আলাদা রাখা
- Evaluation ও red teaming: adversarial evaluation-এর scope কীভাবে ঠিক করা, কী benchmark ও evaluation dataset আছে এবং ফল কীভাবে ব্যাখ্যা করতে হয়
- AI observability: AI system-এর প্রয়োজনীয় log ও telemetry এবং incident detection ও response-এ তাদের ব্যবহার
- AI-নির্দিষ্ট incident response: AI incident scenario-র পূর্বপরিকল্পনা, model behavior-সংক্রান্ত প্রমাণ সংগ্রহ এবং AI-নির্দিষ্ট recovery বিবেচনা
- Data leakage prevention: RAG isolation, prompt confidentiality, multi-tenant access control এবং output filtering
এখনই তোমার কী করা উচিত
তোমার প্রতিষ্ঠানের AI system-এর দায়িত্বে থাকলে:
OWASP Top 10 for Large Language Model Applications এবং OWASP Agentic AI Top 10 পড়ো। এগুলো বিনামূল্যে এবং বর্তমান paid certification curriculum-এর চেয়ে operational দিক থেকে বেশি নির্দিষ্ট।
AI component নিয়ে পরবর্তী threat modeling session-এর আগে MITRE ATLAS পর্যালোচনা করো। deployment design চূড়ান্ত করার আগে তোমার architecture-এ কোন adversary tactic প্রযোজ্য তা জানো।
NIST AI 600-1 পড়ো। এটি মূল AI RMF-কে generative AI-এর জন্য বিশেষভাবে বাড়ায় এবং শুধু মূল framework-এর চেয়ে LLM ও agent deployment-এর জন্য বেশি প্রাসঙ্গিক।
Google SAIF, Microsoft’s AI SDL এবং OWASP AI Exchange দেখো। এগুলো governance framework-এ না থাকা engineering নির্দেশনা দেয়।
তোমার প্রতিষ্ঠান যে প্রতিটি model deployment করে, তার provenance যাচাই করো। model card দেখো। weight load করার আগে পরিচিত exploit class আছে কি না serialization format scan করো।
তোমার environment-এর প্রতিটি AI agent-এর access map করো। internal knowledge base, email ও file system-এ read/write access-সহ agent prompt injection-এর প্রভাব বাড়ায়। প্রতিটি কাজের জন্য যত credential দরকার, ততটুকুই রাখো।
উচ্চ-পরিণতির পরিবেশে model বা agent deployment-এর আগে AI-নির্দিষ্ট red teaming বাধ্যতামূলক করো। এটিকে ঐচ্ছিক নয়, আবশ্যক ধরো।
প্রয়োজন হওয়ার আগেই AI-নির্দিষ্ট incident response runbook তৈরি করো।
তোমার governance সার্টিফিকেশনকে process layer-এর নথি হিসেবে ধরো। এটি তোমার security posture-এর নথি নয়।
তথ্যসূত্র
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
Related Posts