2x RTX 5060 Ti বনাম GB10: কেন 32 GB VRAM, 128 GB ইউনিফায়েড মেমরির কাছে হারে
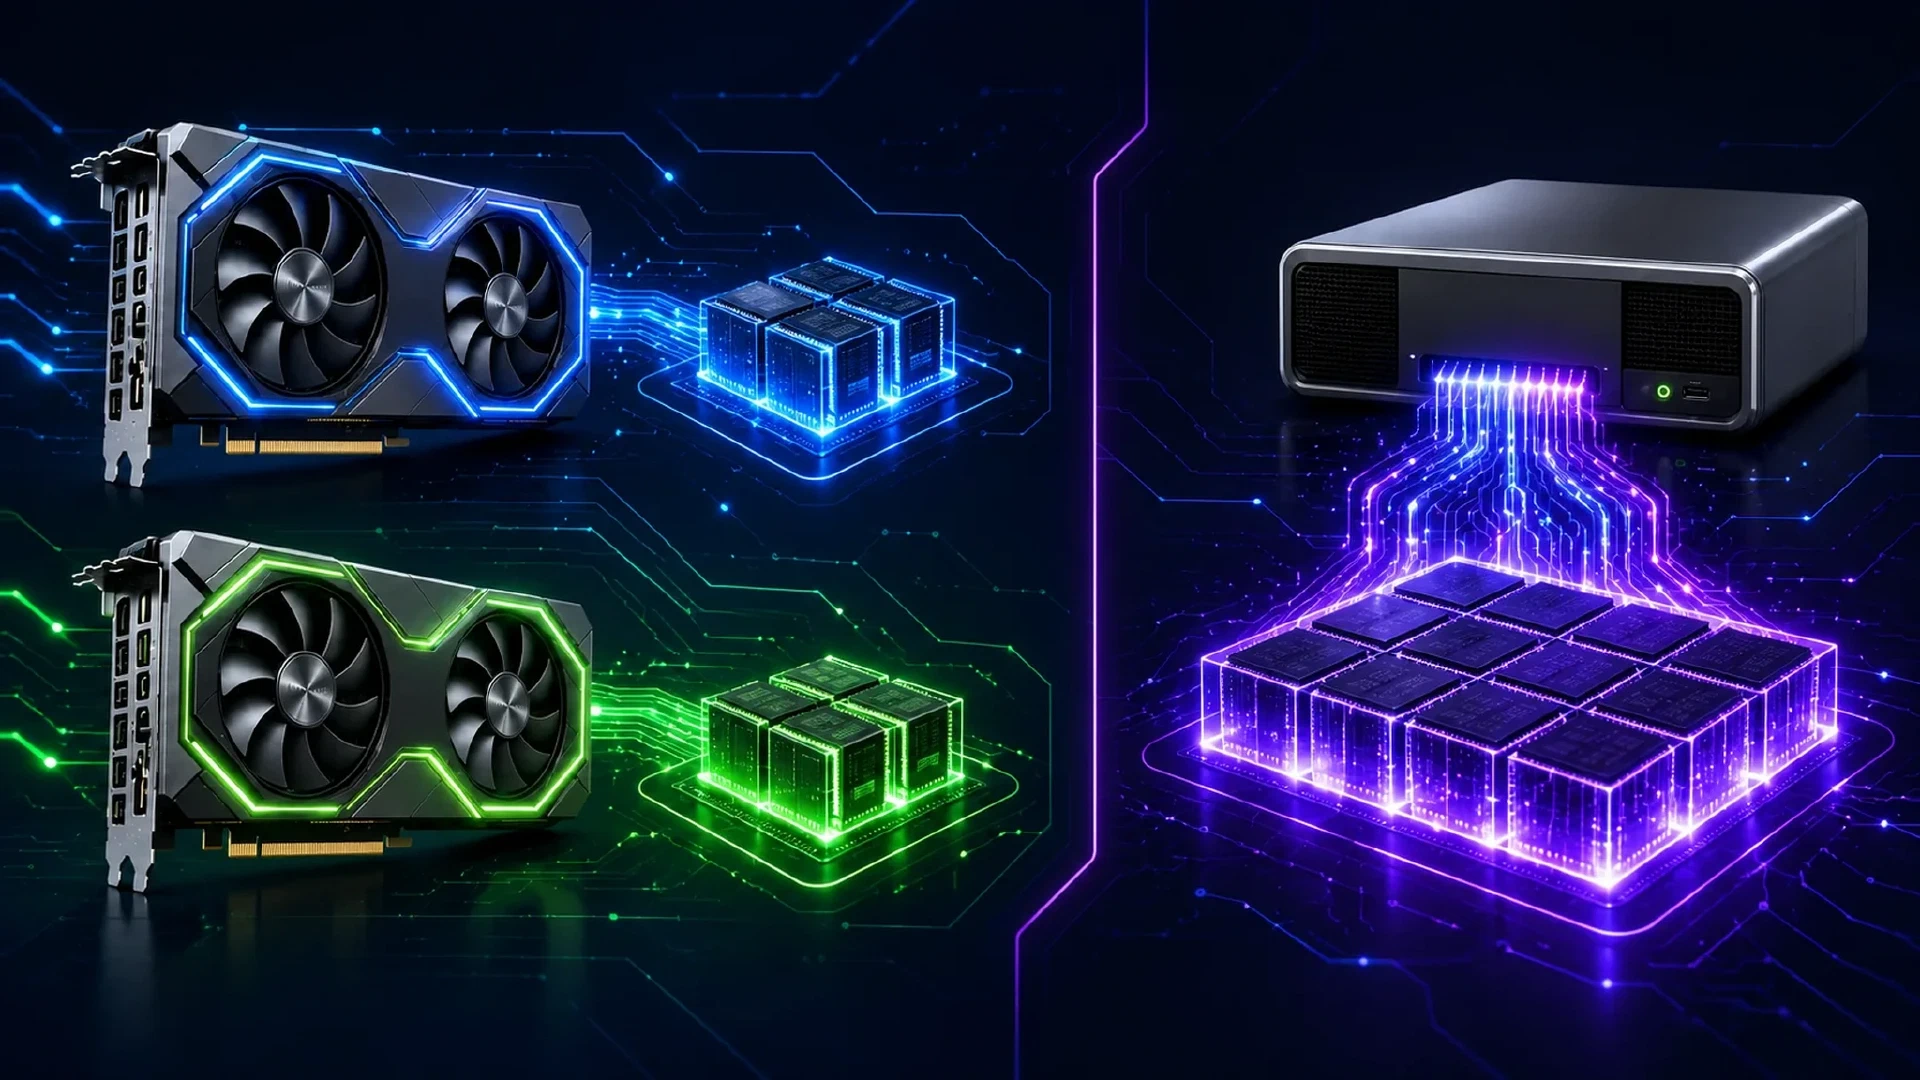
Table of Contents
16 GB-এর দুটি RTX 5060 Ti একটি পার্টস তালিকায় আকর্ষণীয় দেখায়। এগুলো মোট 32 GB VRAM এবং ছোট কনটেক্সটে দ্রুত প্রম্পট প্রসেসিং দেয়। 27B মডেল দীর্ঘ কনটেক্সটে চালালে তুলনাটি বদলে যায়।
NVIDIA GB10 সিস্টেম 128 GB সমন্বিত ইউনিফায়েড মেমরি ব্যবহার করে। NVIDIA GB10 প্ল্যাটফর্মের জন্য 128 GB LPDDR5x ইউনিফায়েড মেমরি এবং 140 W চিপ TDP উল্লেখ করে। RTX 5060 Ti প্রতি কার্ডে 16 GB GDDR7, 128-বিট মেমরি ইন্টারফেস এবং 180 W মোট গ্রাফিক্স পাওয়ার ব্যবহার করে। NVIDIA RTX 5060 Ti-এর স্পেসিফিকেশন এবং NVIDIA GB10-এর স্পেসিফিকেশন হার্ডওয়্যারের পার্থক্য দেখায়।
মূল বিষয়টি সহজ। 16 GB-এর দুটি কার্ড একটি দ্রুত 32 GB মেমরি পুল তৈরি করে না। এগুলো হোস্ট সিস্টেমের মাধ্যমে যুক্ত দুটি আলাদা 16 GB পুল তৈরি করে। বড় মডেলের ইনফারেন্সে কার্ডের সংখ্যার চেয়ে কম ক্ষমতা এবং ডিভাইসগুলোর মধ্যে ডেটা স্থানান্তর বেশি গুরুত্বপূর্ণ।
মেমরি তুলনা
| সিস্টেম | মেমরি | মেমরি মডেল | উল্লেখিত পাওয়ার মান |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | মোট 32 GB | দুটি আলাদা GPU মেমরি পুল | মোট GPU 360 W |
| GB10 সিস্টেম | 128 GB | সমন্বিত ইউনিফায়েড সিস্টেম মেমরি | GB10 TDP 140 W |
GB10 জেতে না কারণ 128 GB LPDDR5x মেমরি উচ্চমানের বিচ্ছিন্ন GPU-এর মেমরি ব্যান্ডউইথের সমান। সুবিধাটি আসে ক্ষমতা ও অবস্থান থেকে। CPU এবং GPU একই অ্যাড্রেস স্পেস ভাগ করে। তাই মডেল, রানটাইম বাফার, অ্যাক্টিভেশন এবং কনটেক্সট ডেটাকে দুটি আলাদা 16 GB ডিভাইসের মধ্যে ফিট করতে হয় না।
দুই-কার্ড সিস্টেমে ডেটা বসানোর সমস্যা কঠিন। মডেলকে দুই কার্ডে ভাগ করতে হয়। ইনফারেন্স রানটাইমকে কার্ড দুটির মধ্যে ডেটা সরাতে হয়। PCIe ট্রাফিক লেটেন্সি যোগ করে এবং ব্যান্ডউইথ ব্যবহার করে। NVIDIA-এর স্পেসিফিকেশন অনুযায়ী RTX 5060 Ti NVLink সমর্থন করে না।
বেঞ্চমার্কের ফলাফল
নিচের ফলাফল সরবরাহ করা AI বেঞ্চমার্ক রিপোর্ট থেকে নেওয়া। রিপোর্টটি নামহীন একটি dual-GPU সিস্টেম, যার নাম 5060ti-x2, এবং একটি GB10 সিস্টেমের তুলনা করে। পরীক্ষায় বিভিন্ন কনটেক্সট আকারে Qwen এবং GPT-OSS ব্যবহৃত হয়েছে।
মডেলগুলো সরাসরি Ollama থেকে নেওয়া হয়েছে। পরীক্ষায় আক্ষরিক ডিফল্ট ট্যাগ qwen3.8:27b এবং gpt-oss:latest ব্যবহার করা হয়েছে। কোনো কাস্টম Modelfile বা বিকল্প কোয়ান্টাইজেশন ব্যবহার করা হয়নি। 5060ti-x2 সিস্টেমে PCIe Gen4 x16 এবং পরীক্ষার সময় পাওয়া সর্বশেষ NVIDIA Linux ড্রাইভার ব্যবহার করা হয়েছে।
Qwen প্রম্পট প্রসেসিং এবং জেনারেশন
| কনটেক্সট | 5060ti-x2 প্রম্পট tok/s | 5060ti-x2 জেনারেশন tok/s | GB10 প্রম্পট tok/s | GB10 জেনারেশন tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
4K-তে দুই-কার্ড সিস্টেম GB10-এর প্রায় দ্বিগুণ গতিতে জেনারেট করে। 64K-তে ব্যবধান প্রায় 1.5 গুণে নামে। 128K-তে দুটি সিস্টেমের জেনারেশন গতি প্রায় সমান হয়।
256K-তে দুই-কার্ড বিল্ড আর বিজয়ী দেখায় না। 5060ti-x2 অনুরোধ মাত্র 171,359টি প্রকৃত প্রম্পট টোকেনে পৌঁছায়। জেনারেশন 1.2 টোকেন প্রতি সেকেন্ডে নেমে যায়। GB10 সম্পূর্ণ 256K পরীক্ষা 25.8 টোকেন প্রতি সেকেন্ডে শেষ করে।
পরীক্ষিত 256K ফলাফলে GB10 প্রায় 21.5 গুণ দ্রুত জেনারেট করেছে। আরও গুরুত্বপূর্ণ, GB10 চাওয়া কনটেক্সট সম্পূর্ণ করেছে। দুই-কার্ড সিস্টেম একই ওয়ার্কলোড দিতে পারেনি।
কেন মোট VRAM বিভ্রান্তিকর
1. মডেল একটি 32 GB কার্ড দেখতে পায় না
দুটি GPU তাদের মেমরি একত্র করে একটি স্থানীয় অ্যাড্রেস স্পেস তৈরি করে না। মডেল-প্যারালাল রানটাইম স্তর বা টেনসর ডিভাইসগুলোর মধ্যে ভাগ করে। প্রতিটি ডিভাইসের নিজের ওজন, অস্থায়ী বাফার এবং কনটেক্সট স্টেটের একটি অংশের জন্য জায়গা লাগে।
তাই ব্যবহারযোগ্য ক্ষমতা সাধারণ যোগফলের চেয়ে কম। সঠিক ওভারহেড মডেল ফরম্যাট, কোয়ান্টাইজেশন, ইনফারেন্স ব্যাকএন্ড, টেনসর বিভাজন এবং কনটেক্সট দৈর্ঘ্যের ওপর নির্ভর করে।
2. জেনারেশনের সময় কনটেক্সট মেমরি বাড়ে
মডেল ওজন মেমরি বাজেটের এক অংশ মাত্র। key-value cache বা KV cache আগের টোকেনের attention ডেটা রাখে। দীর্ঘ কনটেক্সটে বেশি ক্যাশ মেমরি লাগে। 4K পরীক্ষা 128K বা 256K ডিপ্লয়মেন্টের পূর্বাভাস দেয় না।
সরবরাহ করা ফলাফল এই সীমাটি স্পষ্ট করে। দুই-কার্ড সিস্টেম প্রম্পট প্রসেসিংয়ে এগিয়ে থাকে, পরে কনটেক্সট বাড়লে জেনারেশন কর্মক্ষমতা হারায়। 4K থেকে 256K পর্যন্ত GB10 প্রতি সেকেন্ডে প্রায় 26 থেকে 29টি জেনারেশন টোকেন ধরে রাখে।
3. PCIe ট্রান্সফার অতিরিক্ত খরচ যোগ করে
রানটাইম GPU-গুলোর মধ্যে অ্যাক্টিভেশন বা টেনসর সরালে ট্রান্সফার হোস্ট ইন্টারকানেক্ট পার হয়। প্রতিটি ধাপে এতে সিঙ্ক্রোনাইজেশন পয়েন্ট ও অতিরিক্ত লেটেন্সি তৈরি হয়। ওয়ার্কলোড বারবার ডিভাইস সীমা পার হলে শাস্তি বাড়ে।
এতে dual-GPU সিস্টেম অকেজো হয় না। মেমরি অবস্থান কর্মক্ষমতার অংশ। শুধু 4K প্রম্পট প্রসেসিং রিপোর্ট করা বেঞ্চমার্ক এই খরচ দেখায় না।
4. পাওয়ার দক্ষতা সিস্টেম-স্তরের সুবিধা
তুলনায় GB10 কম পাওয়ার ব্যবহার করে এবং পরীক্ষিত দীর্ঘ-কনটেক্সট ওয়ার্কলোডের জন্য বেশি মেমরি ক্ষমতা দেয়। বাকি সিস্টেম বাদ দেওয়ার আগে দুটি RTX 5060 Ti মিলিয়ে 360 W GPU পাওয়ার বহন করে। NVIDIA GB10-এর TDP 140 W বলে।
GB10 সর্বোচ্চ ছোট-কনটেক্সট গতি বদলে ক্ষমতা, সম্পূর্ণতা এবং কম GPU পাওয়ার দেয়। দীর্ঘ-কনটেক্সট Qwen ইনফারেন্সে এই বিনিময়গুলো গুরুত্বপূর্ণ।
5060ti-x2 সিস্টেমের দাম অনেক কম
কর্মক্ষমতার তুলনা দামের পার্থক্য মুছে দেয় না। 16 GB-এর দুটি RTX 5060 Ti-সহ একটি সম্পূর্ণ ওয়ার্কস্টেশনের দাম 10 অক্টোবর 2026-এ $3,479 তালিকাভুক্ত ছিল। এতে Intel Ultra 7 265K, Z890 মাদারবোর্ড, 32 GB DDR5, 1 TB স্টোরেজ, 1,000 W পাওয়ার সাপ্লাই এবং দুটি GPU আছে। সম্পূর্ণ dual-GPU ওয়ার্কস্টেশন তালিকা দেখুন ।
NVIDIA-এর US marketplace 128 GB DGX Spark-এর দাম $6,950 দেখায়। তালিকায় 128 GB সমন্বিত ইউনিফায়েড মেমরি এবং 4 TB NVMe স্টোরেজ আছে, তবে সিস্টেমটি স্টকে নেই। NVIDIA-এর বর্তমান DGX Spark তালিকা দেখুন ।
AMD Ryzen AI Halo Developer Platform আরেকটি তুলনা দেয়। এই Strix Halo সিস্টেমের Micro Center মূল্য $3,999.99, সঙ্গে 128 GB LPDDR5x ইউনিফায়েড মেমরি এবং 2 TB স্টোরেজ। Strix Halo প্রায়ই GB10 সিস্টেমের মতো একই ব্যবহারিক স্থানীয়-AI শ্রেণিতে পড়ে, যদিও স্বাধীন পরীক্ষায় থ্রুপুট ও সফটওয়্যার পরিপক্বতায় GB10 এগিয়ে থাকে। Micro Center-এর বর্তমান Linux তালিকা দেখুন এবং Strix Halo বনাম GB10 পর্যালোচনা পড়ুন ।
| সম্পূর্ণ সিস্টেম | 10 অক্টোবর 2026-এর তালিকাভুক্ত দাম | দামের পার্থক্য |
|---|---|---|
| 5060ti-x2 ওয়ার্কস্টেশন | $3,479 | ভিত্তি |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 বেশি |
| 128 GB GB10 DGX Spark | $6,950 | $3,471 বেশি |
GB10 বড় ইউনিফায়েড মেমরি পুল, কম পাওয়ার ব্যবহার এবং দীর্ঘ-কনটেক্সটের জন্য ভালো আর্কিটেকচার দেয়। AMD সিস্টেম প্রায় $4,000-এ একই 128 GB মেমরি শ্রেণি দেয়। কর ও শিপিংয়ের আগে 5060ti-x2 ওয়ার্কস্টেশনের দাম তালিকাভুক্ত GB10 দামের প্রায় 50%। NVIDIA-এর সফটওয়্যার স্ট্যাক দরকার না হলে ইউনিফায়েড মেমরি চাওয়া ক্রেতাদের জন্য Strix Halo কম দামের বিকল্প।
এগুলো আলাদা বিক্রেতার তালিকাভুক্ত দাম, নিয়ন্ত্রিত খুচরা ঝুড়ি নয়। তুলনায় 5060ti-x2 সিস্টেমে কম সিস্টেম মেমরি ও স্টোরেজও আছে। তবু দামের ব্যবধান গুরুত্বপূর্ণ, কারণ দুটি তালিকাই আলাদা GPU দামের বদলে সম্পূর্ণ ব্যবহারযোগ্য কম্পিউটার বর্ণনা করে। বর্তমান 16 GB RTX 5060 Ti কার্ডের দাম প্রতি কার্ড $789 থেকে $830, যা $429 লঞ্চ MSRP-এর চেয়ে অনেক বেশি। বর্তমান GPU মূল্যবৃদ্ধির মধ্যেও দুই-কার্ডের দামের সুবিধা থাকে। বর্তমান RTX 5060 Ti মূল্য যাচাই ।
GPT-OSS ফলাফল আলাদাভাবে দেখতে হবে
একই রিপোর্টে 4K থেকে 256K পর্যন্ত 5060ti-x2-এ GPT-OSS-এর শক্তিশালী জেনারেশন ফলাফল দেখা যায়। GB10 4K থেকে 128K পরীক্ষা সম্পূর্ণ করে, কিন্তু 256K GPT-OSS পরীক্ষা unsupported হিসেবে চিহ্নিত।
সার্বজনীন বিজয়ী দাবি করতে GPT-OSS টেবিল ব্যবহার করবেন না। 256K-তে পরীক্ষাগুলো একই পরিসর কভার করে না। Qwen দীর্ঘ-কনটেক্সটের পরিষ্কার তুলনা দেয়, কারণ দুই সিস্টেমই 256K ফলাফল দেয়, যদিও 5060ti-x2 রান মাত্র 171,359 প্রকৃত প্রম্পট টোকেনে পৌঁছায়।
Qwen 3 27B বিল্ডের জন্য এর অর্থ
16 GB-এর দুই-কার্ড সেটআপ ছোট কনটেক্সটে একটি কোয়ান্টাইজড 27B মডেল চালাতে পারে। বেঞ্চমার্ক এমন ব্যবহার অস্বীকার করে না। ডেটা এই দাবি অস্বীকার করে যে 32 GB মোট VRAM, 128 GB ইউনিফায়েড-মেমরি সিস্টেমের সমান ব্যবহারিক অবকাশ দেয়।
একটি কার্ডে মডেল ফিট হওয়া শুধু ওজন ধারণক্ষমতা প্রমাণ করে। প্রকৃত মেমরি চাহিদায় মডেল ওজন, সক্রিয় কনটেক্সট, KV cache, রানটাইম বাফার এবং অপারেটিং-সিস্টেম অবকাশ আছে। মডেলের পাশে কনটেক্সটকেও ফিট করতে হবে। মডেল লোড হলেও কাজের কথোপকথনের জন্য জায়গা না থাকলে সেটি ব্যবহারযোগ্য দীর্ঘ-কনটেক্সট সেটআপ নয়।
এটি গুরুতর স্থানীয় LLM কাজের জন্য 16GB VRAM কি যথেষ্ট? sizing নির্দেশিকার সঙ্গে মেলে। সেখানে ওজন, কনটেক্সট এবং রানটাইম বরাদ্দকে এক বাজেট ধরা হয়েছে। Qwen 27B-এর জন্য 32GB VRAM গাইড দুই-কার্ড বিল্ডের জন্য একই সিদ্ধান্তে পৌঁছায়। মোট ক্ষমতা ব্যবহারযোগ্য অবকাশের সমান নয়।
Qwen 3 27B ডিপ্লয় করার আগে হার্ডওয়্যার কেনার সময় চারটি প্রশ্ন করুন:
- রানটাইম বাফারসহ চাওয়া কোয়ান্টাইজেশন কি ফিট করে? মডেল ওজন একা মেমরি চাহিদা নির্ধারণ করে না।
- তীব্র KV-cache চাপ ছাড়া কনটেক্সট কি ফিট করে? দীর্ঘ প্রম্পট ফলাফল বদলে দেয়।
- রানটাইম কি দ্রুত ডিভাইস বিভাজন ব্যবহার করে? PCIe ট্রান্সফার ও টেনসর অবস্থান প্রতিটি উৎপন্ন টোকেনকে প্রভাবিত করে।
- সিস্টেম কি লক্ষ্য কনটেক্সট সম্পূর্ণ করে? দ্রুত 4K ফলাফল ব্যর্থ 256K ওয়ার্কলোড পূরণ করতে পারে না।
সরবরাহ করা পরীক্ষা দুই-কার্ড সিস্টেমের জন্য শেষ প্রশ্নটির উত্তর দেয়। 256K Qwen অনুরোধে রানটি 171,359 টোকেনে পৌঁছে এবং প্রতি সেকেন্ডে 1.2 টোকেন জেনারেট করে। GB10 প্রতি সেকেন্ডে 25.8 টোকেনে 256K সম্পূর্ণ করে।
এই দীর্ঘ-কনটেক্সট ওয়ার্কলোডে, বিকল্পটি মডেলের working set বিস্তৃত করতে PCIe-এর ওপর নির্ভর করলে ইউনিফায়েড মেমরি ভালো আর্কিটেকচার। PCIe ক্ষমতার একটি workaround। PCIe একই মেমরি পুল, লেটেন্সি বা ট্রান্সফার পথ তৈরি করে না। স্থানীয় AI GPU কনটেক্সট গাইড ব্যাখ্যা করে কেন মডেল ওজন, KV cache, টুল আউটপুট এবং রানটাইম বাফার একসঙ্গে মাপতে হয়। Ollama Qwen3.8 27B GPU বেঞ্চমার্ক দেখায় কেন দীর্ঘ-কনটেক্সট ফলাফলকে ছোট-কনটেক্সট ডিকোড সংখ্যার থেকে আলাদাভাবে দেখা দরকার।
রায়
দীর্ঘ-কনটেক্সট 27B ইনফারেন্সের লক্ষ্য হলে 16 GB-এর দুটি RTX 5060 Ti, GB10-এর দুর্বল বিকল্প। ছোট কনটেক্সটে এগুলো বেশি প্রম্পট থ্রুপুট দেয়। এগুলো বেশি GPU পাওয়ারও ব্যবহার করে এবং রানটাইমকে বিভক্ত মেমরি লেআউটের মুখে ফেলে।
সরবরাহ করা ফলে GB10 প্রম্পট প্রসেসিংয়ে ধীর। সিস্টেমটি বেশি পাওয়ার-দক্ষ, চার গুণ মোট মেমরি দেয় এবং ব্যবহারযোগ্য জেনারেশন গতিতে সম্পূর্ণ 256K Qwen পরীক্ষা শেষ করে।
আপনি ছোট প্রম্পট চালালে এবং প্রম্পট গ্রহণকে মূল্য দিলে 5060ti-x2-এর একটি সীমিত ব্যবহার আছে। 27B মডেলের জন্য বড় ইউনিফায়েড মেমরি পুল ভালো, কারণ মডেল ও কনটেক্সট একটি সমন্বিত working set ভাগ করে। PCIe ট্রান্সফার ইনফারেন্স পথে ঢুকলে ইউনিফায়েড মেমরি বেশি উপযোগী থাকে।
বেঞ্চমার্কটি দেখায় না যে দুটি RTX 5060 Ti কখনও Qwen 3 27B শুরু করতে পারে না। ডেটা দেখায়, মডেল শুরু করা এবং ওয়ার্কলোড ভালোভাবে চালানো এক বিষয় নয়।
বেঞ্চমার্কের সীমা
সরবরাহ করা রিপোর্টে আক্ষরিক Ollama ট্যাগ আছে, কিন্তু সমাধান করা manifest digest, মডেল রিভিশন, CPU, পাওয়ার মাপ বা কুলিং সেটআপ নেই। রিপোর্টে 5060ti-x2 সিস্টেমের জন্য PCIe Gen4 x16 এবং পরীক্ষার সময়ের বর্তমান NVIDIA Linux ড্রাইভারও উল্লেখ আছে। সংখ্যাগুলোকে পর্যবেক্ষণ করা সিস্টেমের তুলনা হিসেবে দেখুন, প্রতিটি RTX 5060 Ti জোড়া ও প্রতিটি GB10 বাস্তবায়নের সার্বজনীন র্যাঙ্কিং হিসেবে নয়।
উপরের হার্ডওয়্যার স্পেসিফিকেশন NVIDIA থেকে এসেছে। কর্মক্ষমতার সংখ্যা এই নিবন্ধের জন্য সরবরাহ করা বেঞ্চমার্ক ডেটা থেকে এসেছে।
রেফারেন্স
- Ollama Qwen3.8 মডেল লাইব্রেরি
- Ollama GPT-OSS মডেল ট্যাগ
- গুরুতর স্থানীয় LLM কাজের জন্য 16GB VRAM কি যথেষ্ট?
- Qwen 27B-এর জন্য 32GB VRAM
- স্থানীয় AI GPU কনটেক্সট গাইড
- Vast.ai-তে Qwen3.8 27B GPU বেঞ্চমার্ক
- সম্পূর্ণ dual RTX 5060 Ti 16 GB ওয়ার্কস্টেশন তালিকা
- NVIDIA DGX Spark US marketplace তালিকা
- AMD Ryzen AI Halo 128 GB Linux তালিকা
- Tom’s Hardware Strix Halo বনাম GB10 পর্যালোচনা
- বর্তমান RTX 5060 Ti মূল্য যাচাই
Related Posts