2026-10-10
(সর্বশেষ পরিবর্তন:
2026-10-10)
— লেখা
SimeonOnSecurity
— 10 মিনিটের পঠন সময় এআই অবকাঠামোতে ব্যয়, ডেটা সেন্টারের বিদ্যুৎ চাহিদা, অর্থায়ন কাঠামো, প্রতিষ্ঠানের মূল্য এবং বাজারকে বুদবুদ বলার আগে প্রয়োজনীয় প্রমাণের তথ্যভিত্তিক পর্যালোচনা।
2026-10-10
(সর্বশেষ পরিবর্তন:
2026-10-10)
— লেখা
SimeonOnSecurity
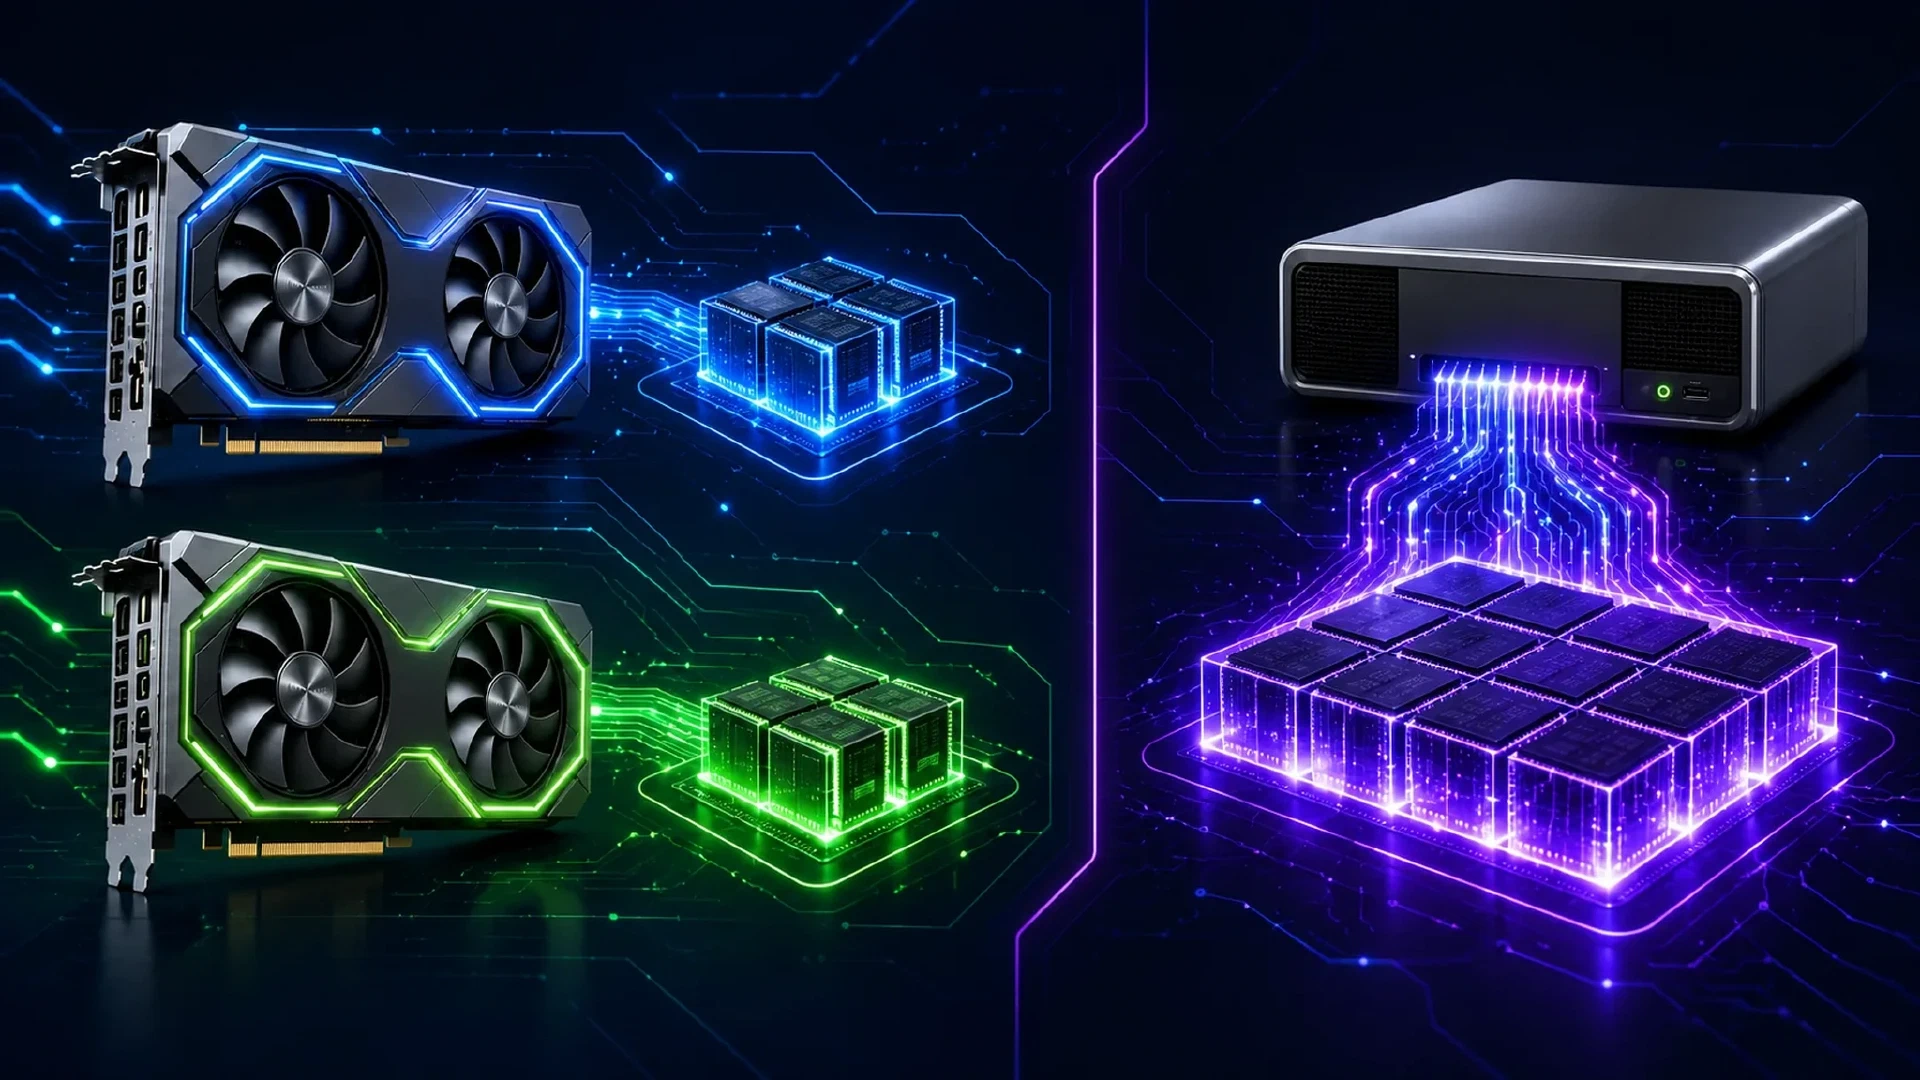
— 8 মিনিটের পঠন সময় Qwen 3 27B এবং দীর্ঘ-কনটেক্সট স্থানীয় ইনফারেন্সের জন্য দুটি 16 GB RTX 5060 Ti কার্ড ও একটি NVIDIA GB10 সিস্টেমের বেঞ্চমার্ক-ভিত্তিক তুলনা।
স্থানীয় মডেলের কর্মক্ষমতা শুধু GPU সংখ্যার ওপর নয়, মেমরি আর্কিটেকচারের ওপর নির্ভর করে। #স্থানীয় LLM
#VRAM
2026-10-10
(সর্বশেষ পরিবর্তন:
2026-10-10)
— লেখা
SimeonOnSecurity
— 8 মিনিটের পঠন সময় স্থানীয় inference বা hosted AI service বেছে নেওয়ার আগে prompt, model file, tool, log, network exposure এবং বিদ্যুৎ খরচ অনুসরণ করুন।
স্থানীয় ও hosted AI data path-এর চিত্র #llama.cpp
2026-10-07
(সর্বশেষ পরিবর্তন:
2026-10-10)
— লেখা
SimeonOnSecurity
— 9 মিনিটের পঠন সময় মডেল ওজন, KV cache এবং prompt processing অনুযায়ী 16GB স্থানীয় LLM সেটআপের আকার নির্ধারণ করুন। Qwen3.8 27B memory budget, GPU bandwidth এবং ownership cost তুলনা করুন।
চিত্র, benchmark output নয় #স্থানীয় LLM
#llama.cpp
2026-10-06
(সর্বশেষ পরিবর্তন:
2026-10-10)
— লেখা
SimeonOnSecurity
— 9 মিনিটের পঠন সময় Strata এবং OpenCode দিয়ে একটি লোকাল কোডিং এজেন্ট চালান। প্রকাশিত RTX 4060 Ti ফলাফল, RAM প্রয়োজনীয়তা, প্রম্পট পুনর্ব্যবহার, reasoning বাজেট এবং পেইড সাবস্ক্রিপশন বদলানোর সীমা পরীক্ষা করুন।